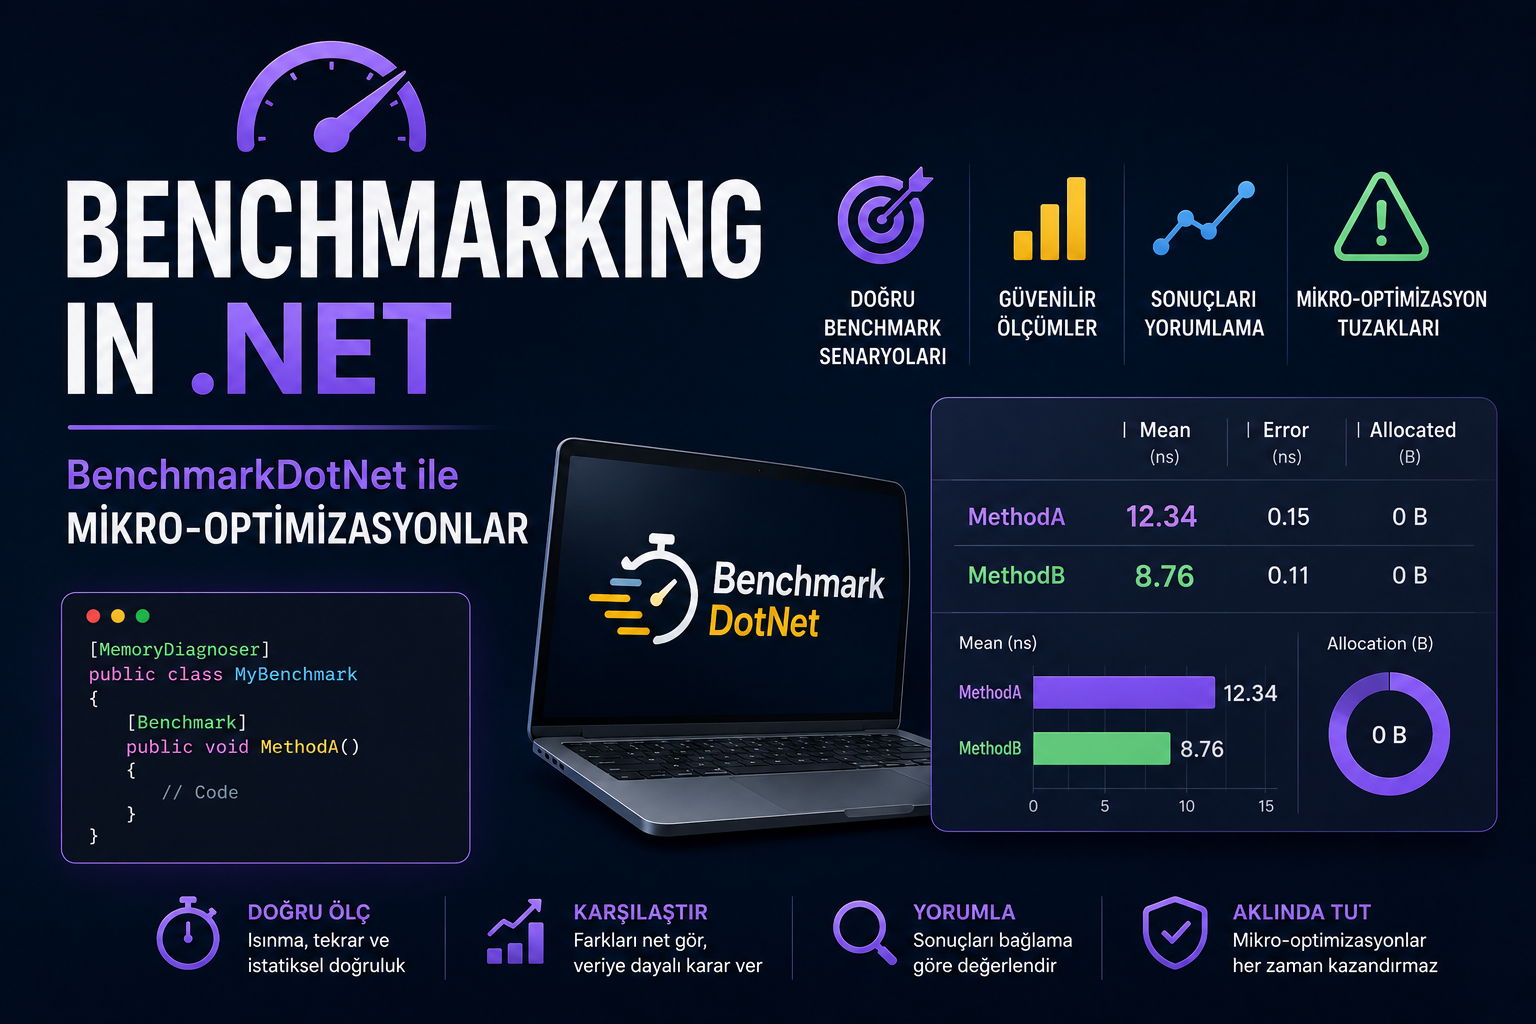
BenchmarkDotNet ile Mikro-Optimizasyon: Veriyle Kanıtlanmış Performans
Yazılım geliştirmede en tehlikeli düşünce "Bunun daha hızlı olduğunu hissediyorum"dur. JIT derleyicisi, CPU ön belleği (cache), branch prediction ve Garbage Collector (GC) o kadar karmaşıktır ki, bir kod parçasının hangi ortamda nasıl çalışacağını tahmin etmek neredeyse imkânsızdır. İşte BenchmarkDotNet (BDN), bu tahminleri bilimsel verilere dönüştüren, .NET ekosisteminin altın standart kütüphanesidir. Bu yazıda, BDN'yi doğru kurmayı, sonuçları okumayı ve mikro-optimizasyon tuzaklarından kaçınmayı öğreneceksiniz.
1. BenchmarkDotNet Kurulumu ve İlk Benchmark
BDN, bir konsol uygulaması olarak çalışır ve metodlarınızı izole edilmiş süreçlerde defalarca çalıştırarak istatistiksel olarak anlamlı veriler toplar.
Adım 1: Yeni bir Console App (.NET 6/8) oluşturun ve NuGet'ten BenchmarkDotNet paketini ekleyin.
Adım 2: Benchmark sınıfınızı yazın:
csharp
using BenchmarkDotNet.Attributes;
using BenchmarkDotNet.Running;

[MemoryDiagnoser] // Bellek tahsisini (Allocation) da ölç!
public class StringConcatBenchmark
{
    private string _baseString = "Hello";
    private string _repeatString = "World!";

    [Benchmark(Baseline = true)] // Referans noktası (karşılaştırma bazı)
    public string UsingPlusOperator()
    {
        return _baseString + " " + _repeatString;
    }

    [Benchmark]
    public string UsingStringConcat()
    {
        return string.Concat(_baseString, " ", _repeatString);
    }

    [Benchmark]
    public string UsingStringBuilder()
    {
        var sb = new System.Text.StringBuilder();
        sb.Append(_baseString);
        sb.Append(' ');
        sb.Append(_repeatString);
        return sb.ToString();
    }
}

// Program.cs
public class Program
{
    public static void Main(string[] args)
    {
        var summary = BenchmarkRunner.Run<StringConcatBenchmark>();
    }
}
Çalıştırma: Projeyi RELEASE modunda çalıştırın (Debug'da çalıştırmak anlamsızdır, optimizasyonlar devre dışıdır). BDN, önce ısınma (warm-up) turları yapar, sonra ölçüm turlarına başlar.
2. Parametreli Benchmark'lar ([Params])
Gerçek hayatta veri boyutları değişir. [Params] ile aynı metodu farklı girdilerle test edebilirsiniz.
csharp
public class CollectionBenchmark
{
    [Params(10, 100, 1000, 10000)] // Farklı koleksiyon boyutları
    public int N { get; set; }

    private List<int> _list;
    private int[] _array;

    [GlobalSetup] // Her N değeri için bir kez çalışır
    public void Setup()
    {
        _list = Enumerable.Range(0, N).ToList();
        _array = Enumerable.Range(0, N).ToArray();
    }

    [Benchmark]
    public int SumList() => _list.Sum();

    [Benchmark]
    public int SumArray() => _array.Sum();
}
Bu benchmark sonucunda, hangi boyutta List ve Array arasındaki farkın değiştiğini net görebilirsiniz.
3. Sonuçları Yorumlama (Terminoloji)
BDN çıktısı şuna benzer:
| Method | Mean | Error | StdDev | Gen0 | Allocated |
|---|---|---|---|---|---|
| UsingPlus | 12.45 ns | 0.32 ns | 0.28 ns | - | - |
| UsingBuilder | 45.67 ns | 0.89 ns | 0.83 ns | 0.01 | 72 B |
-
Mean (Ortalama): Metodun ortalama çalışma süresi (nanosaniye / mikrosaniye). En temel karşılaştırma metriğidir.
-
Error (Hata Payı): İstatistiksel güven aralığı (genelde %99.9). Ne kadar küçükse ölçüm o kadar kararlıdır.
-
StdDev (Standart Sapma): Çalışma sürelerinin ne kadar dağıldığını gösterir. Büyük sapma, GC veya arka plan işlemlerinden etkilenildiğini gösterir.
-
Gen0 / Gen1 / Gen2: 0. nesil (Gen0) GC koleksiyonu sayısı. Eğer bu değer 0'dan büyükse, metodunuz heap tahsisi yapıyor ve GC'yi yoruyor demektir. Bu, CPU süresinden daha önemli olabilir!
-
Allocated (Tahsis): Metodun her çağrıda kaç byte bellek tahsis ettiği (alloc). Bu değer ne kadar düşükse, GC üzerindeki yük o kadar azdır.
Önemli Kural: Mean değerleri birbirine yakınsa (ör. 1.2 ns fark), kazananı belirlemek için Error ve StdDev aralıklarına bakılır. Eğer aralıklar kesişiyorsa, aradaki fark istatistiksel olarak anlamsızdır.
4. En Büyük 3 Mikro-Optimizasyon Tuzağı
Tuzak 1: Ölü Kod Kaldırma (Dead Code Elimination)
csharp
// ❌ KÖTÜ Benchmark
[Benchmark]
public void BadLoop()
{
    for (int i = 0; i < 1000; i++) { } // Hiçbir yan etkisi yok, derleyici bu döngüyü SİLER!
}

// ✅ DOĞRU - Sonucu bir yere ata veya döndür.
[Benchmark]
public int GoodLoop()
{
    int sum = 0;
    for (int i = 0; i < 1000; i++) sum += i;
    return sum; // Bu değer kullanılmazsa derleyici yine silebilir. Bunu önlemek için [MethodImpl(MethodImplOptions.NoInlining)] veya return ile döndür.
}
BDN, return edilen değerleri otomatik olarak tüketir (consume) böylece derleyici optimize edip atamaz. Ancak void dönen metotlarda çok dikkatli olun.
Tuzak 2: DEBUG Modunda Çalıştırmak
Debug modunda JIT optimizasyonları (inlining, loop unrolling) devre dışıdır. Release modunda çalıştırmayanların benchmark sonuçları tamamen çöptür. BDN zaten release'de çalıştırmanız için uyarır.
Tuzak 3: Isınma (Warm-up) Süresini İhmal Etmek
JIT derleyicisi, bir metot ilk çağrıldığında derler (Cold Start). BDN varsayılan olarak bu ısınma turlarını ölçüme dahil etmez (genelde 16 tur). Kaldı ki [IterationCount] veya [WarmupCount] ile bunu manuel kontrol edebilirsiniz. Eğer BDN kullanmıyorsanız (ör. kendi Stopwatch'unuzla), ilk çağrıyı mutlaka ölçüm dışı bırakın.
5. İleri Seviye: Farklı Runtime'ları Karşılaştırma (.NET Framework vs .NET 8)
BDN, aynı kodu farklı .NET sürümlerinde çalıştırmanıza izin verir (Job tanımlarıyla).
csharp
[SimpleJob(RuntimeMoniker.Net472)]
[SimpleJob(RuntimeMoniker.Net80)]
[MemoryDiagnoser]
public class RuntimeCompareBenchmark
{
    // Bu benchmark, .NET Framework 4.7.2 ve .NET 8.0'da ayrı ayrı çalıştırılır.
    // Geçiş yaparken performans kaybı yaşayıp yaşamadığınızı görürsünüz.
}
6. Gerçek Hayat Örneği: foreach vs for Döngüleri
Herkes foreach'in for'dan daha yavaş olduğunu söyler. Doğru mu? Hadi benchmark yapalım:
csharp
[MemoryDiagnoser]
public class LoopBenchmark
{
    private int[] _items;

    [GlobalSetup]
    public void Setup() => _items = Enumerable.Range(0, 1000).ToArray();

    [Benchmark(Baseline = true)]
    public int ForLoop()
    {
        int sum = 0;
        for (int i = 0; i < _items.Length; i++) sum += _items[i];
        return sum;
    }

    [Benchmark]
    public int ForEachLoop()
    {
        int sum = 0;
        foreach (var item in _items) sum += item;
        return sum;
    }

    [Benchmark]
    public int SpanForEach()
    {
        int sum = 0;
        foreach (var item in _items.AsSpan()) sum += item; // Span ile
        return sum;
    }
}
Sonuç: .NET Core 3.0+ ile foreach (Array üzerinde) ve for neredeyse aynı hızdadır. Çünkü JIT, array üzerindeki foreach'i de for döngüsüne çevirir (değer tipi enumerator optimizasyonu). Ancak List<T> üzerinde foreach hala biraz daha yavaştır (çünkü MoveNext property çağrısı yapar). Bu bilgiyi sadece benchmark yaparak öğrenebilirsiniz!
Sonuç ve Altın Kural:
Mikro-optimizasyon yapmak, nanosecond seviyesinde oynamaktır. BenchmarkDotNet size bu oyunu bilimsel kurallarla oynatır.
-
Önce ölç, sonra optimize et.
-
Optimizasyonu kanıtla: Her değişiklikten sonra benchmark'u tekrar çalıştır.
-
Okunabilirlikten ödün verme: Eğer kodunuzu okunamaz hale getirip sadece %1 hız kazanıyorsanız, bu değmez. Sadece kritik sıcak yollarda (hot paths) bu seviyeye inmeye değer.
-
Allokasyon (Alloc) her zaman düşmandır: CPU'dan tasarruf edebilirsiniz ama GC'den kaçamazsınız.
Gen0veAllocatedsütunlarına CPU süresinden daha çok bakın.
Unutmayın: "Tahmin etmek" yanılgıdır, "Ölçmek" gerçektir.