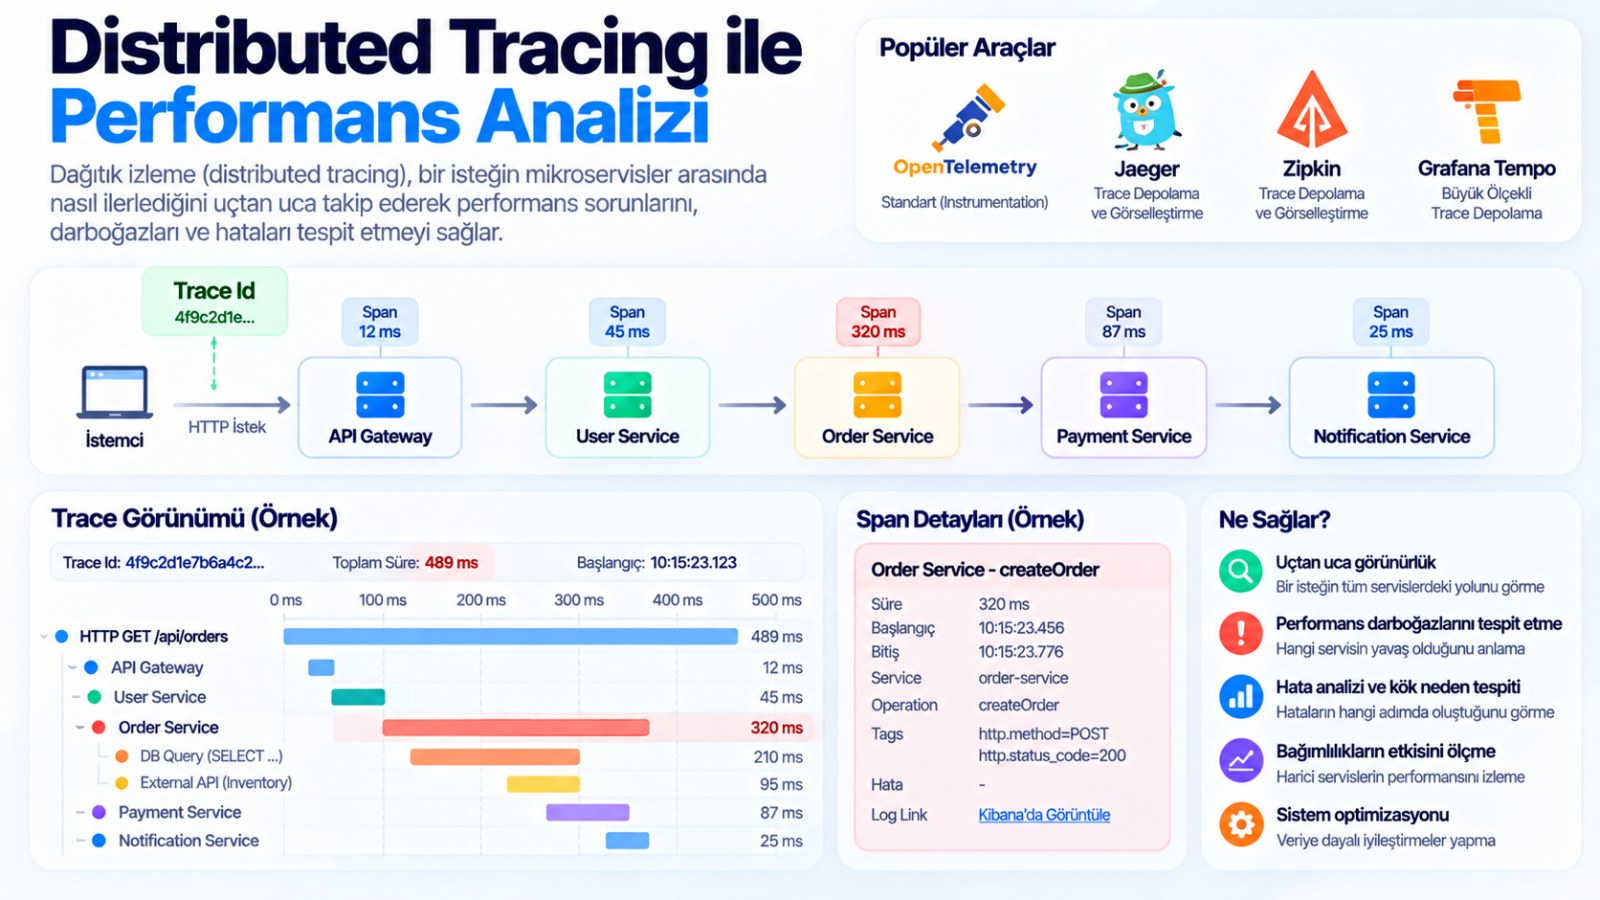
Distributed Tracing ile Performans Analizi
Mikroservis mimarisinde, bir isteğin yavaşlaması durumunda sorunun hangi serviste olduğunu bulmak, log'lar arasında kaybolmak demektir. Distributed Tracing (Dağıtık İzleme), bir isteğin tüm servisler arasındaki yolculuğunu tek bir görselleştirmede birleştirerek performans analizini bilimsel bir disipline dönüştürür. Bu yazıda, distributed tracing verilerini kullanarak performans darboğazlarını nasıl tespit edeceğinizi, yorumlayacağınızı ve gidereceğinizi detaylıca ele alacağız.
1. Trace ve Span: Performansın Yapı Taşları
Trace (İz): Bir isteğin başlangıcından sonuna kadar tüm yolculuğunu temsil eder. Benzersiz bir Trace ID ile tanımlanır.
Span (Aralık): Trace içindeki her bir işlem birimidir. Her span şunları içerir:
-
Span ID: Benzersiz kimlik
-
Parent Span ID: Üst span (hiyerarşi)
-
Start Time / End Time: Başlangıç ve bitiş zamanı
-
Duration: Süre (End - Start)
-
Attributes: HTTP metodu, URL, DB sorgusu, durum kodu
-
Status: OK, Error
Kritik Metrik: duration. Her span'in süresi, o işlemin performansını gösterir.
2. Performans Analizinin Temel Soruları
Distributed tracing verileriyle şu soruları yanıtlayabilirsiniz:
| Soru | Cevap İçin Bakılacak Yer |
|---|---|
| İstek toplam ne kadar sürdü? | Root span duration |
| Hangi servis en yavaş? | Span sürelerini servis bazında karşılaştır |
| Veritabanı mı, ağ mı yavaş? | DB span vs HTTP client span süreleri |
| N+1 sorgusu var mı? | Aynı parent altında çok sayıda DB span |
| Kritik yol (critical path) neresi? | Parent-child zincirinde en uzun süren yol |
| Hata nerede başladı? | Status=Error olan span'ler |
| Yavaşlık yeniden mi ediyor? | Trace'leri zaman içinde karşılaştır |
3. Critical Path Analizi (Kritik Yol Analizi)
Critical Path, bir trace'te isteğin tamamlanmasını belirleyen en uzun süren span zinciridir. Paralel çalışan span'ler arasında, toplam süreyi belirleyen yol kritik yoldur.
Örnek Trace:
text
Root: GET /api/order/123 (Toplam: 1250ms)
├── OrderService.GetOrder (200ms)
├── CustomerService.GetCustomer (300ms)  ← Paralel
├── ProductService.GetItems (400ms)      ← Paralel
└── PaymentService.ProcessPayment (800ms) ← KRİTİK YOL
    └── DB Query (750ms)                  ← ASIL DARBOĞAZ
Analiz:
-
Toplam süre: 1250ms
-
Paralel çalışan 3 servis: en uzunu 400ms
-
PaymentService: 800ms (kritik yol)
-
DB Query: 750ms (asıl darboğaz)
Çıkarım: Diğer servisleri optimize etmek anlamsız; asıl odaklanılması gereken PaymentService'teki DB sorgusu.
Formül:
text
Kritik Yol Süresi = max(paralel dalların süreleri) + sıralı adımlar
Toplam İyileştirme Potansiyeli = Kritik Yol Süresi - İkinci En Uzun Yol
4. Span Sürelerinin Yorumlanması
A. Self-Time vs. Total-Time
-
Total Time: Span'in başlangıcından bitişine kadar geçen süre (child span'ler dahil).
-
Self Time: Span'in kendi işlem süresi (child span'ler hariç).
text
Span A: 500ms (Total)
├── Span B: 300ms (Child)
└── Span C: 150ms (Child)
Self Time (A) = 500 - 300 - 150 = 50ms
Yorum: Span A kendi içinde yalnızca 50ms harcıyor; asıl yük child span'lerde. Optimize edilecek yer Span B.
B. Gap Analizi (Boşluk Analizi)
Child span'ler arasında boşluklar varsa, bu, uygulamanın işlem yapmadan beklediği anlamına gelir (CPU hesaplama, kilit bekleme, GC).
text
Parent Span: 1000ms
├── Child 1: 0-200ms
├── [BOŞLUK: 200-600ms]  ← 400ms açıklanamayan süre
└── Child 2: 600-800ms
Yorum: 400ms'lik boşluk, in-process hesaplama, kilit bekleme veya GC duraklaması olabilir. Detaylı profiling gerekir.
C. N+1 Sorgu Tespiti
Aynı parent span altında çok sayıda benzer DB span görüyorsanız, N+1 problemi vardır.
text
Parent: GetOrders (1200ms)
├── DB Query: SELECT * FROM Orders (50ms)
├── DB Query: SELECT * FROM Customers WHERE Id=1 (20ms)
├── DB Query: SELECT * FROM Customers WHERE Id=2 (20ms)
├── DB Query: SELECT * FROM Customers WHERE Id=3 (20ms)
... (100 kez tekrar)  ← N+1 problemi!
Çözüm: Eager loading (Include), batch sorgu veya DataLoader.
5. OpenTelemetry ile Performans Verisi Toplama
.NET'te Manuel Span ile Detaylı Ölçüm:
csharp
using System.Diagnostics;

public class OrderService
{
    private static readonly ActivitySource ActivitySource = new("OrderService");

    public async Task<Order> GetOrderAsync(int orderId)
    {
        using var activity = ActivitySource.StartActivity("GetOrder");
        activity?.SetTag("order.id", orderId);

        // 1. Veritabanı sorgusu - ayrı span
        using (var dbActivity = ActivitySource.StartActivity("DB.GetOrder"))
        {
            dbActivity?.SetTag("db.system", "postgresql");
            dbActivity?.SetTag("db.statement", "SELECT * FROM Orders WHERE Id = @Id");
            order = await _dbContext.Orders.FindAsync(orderId);
        }

        // 2. Harici servis çağrısı - ayrı span
        using (var httpActivity = ActivitySource.StartActivity("HTTP.GetCustomer"))
        {
            httpActivity?.SetTag("http.method", "GET");
            httpActivity?.SetTag("http.url", $"https://customer-service/api/{order.CustomerId}");
            customer = await _httpClient.GetFromJsonAsync<Customer>(...);
        }

        return order;
    }
}
Bu sayede trace'te her adımın süresi ayrı ayrı görünür ve darboğaz net şekilde tespit edilir.
6. Örnekleme (Sampling) Stratejileri
Yüksek trafikli sistemlerde tüm trace'leri toplamak maliyetlidir. Ancak performans analizi için yavaş trace'leri kaçırmamak kritiktir.
A. Head-Based Sampling (Basit)
csharp
builder.Services.AddOpenTelemetry()
    .WithTracing(tracing => tracing
        .SetSampler(new TraceIdRatioBasedSampler(0.1))  // %10
    );
Dezavantaj: Yavaş trace'ler örnekleme dışında kalabilir.
B. Tail-Based Sampling (Önerilen)
Trace tamamlandıktan sonra karar verilir. Yavaş veya hatalı trace'ler her zaman örneklenir.
yaml
# OpenTelemetry Collector yapılandırması
processors:
  tail_sampling:
    decision_wait: 10s
    policies:
      # 1. Hatalı trace'ler - her zaman al
      - name: errors-policy
        type: status_code
        status_code: { status_codes: [ERROR] }

      # 2. Yavaş trace'ler (>1 saniye) - her zaman al
      - name: slow-traces-policy
        type: latency
        latency: { threshold_ms: 1000 }

      # 3. Diğerleri - %5 örnekle
      - name: random-policy
        type: probabilistic
        probabilistic: { sampling_percentage: 5 }
Avantaj: Performans sorunlarını asla kaçırmazsınız.
7. .NET'te Performans Analizi Araçları
| Araç | Kullanım Alanı |
|---|---|
| OpenTelemetry + Jaeger | Trace toplama ve görselleştirme |
| Grafana Tempo | Ucuz trace depolama, Grafana entegrasyonu |
| Azure Application Insights | Otomatik enstrümantasyon, application map |
| dotnet-trace | .NET runtime trace toplama (GC, JIT, thread) |
| dotnet-counters | Canlı metrik izleme (CPU, GC, ThreadPool) |
| BenchmarkDotNet | Mikro-benchmark |
| PerfView | Derinlemesine CPU/bellek analizi |
dotnet-trace ile Runtime Performans Analizi:
bash
# Çalışan uygulamadan trace al
dotnet-trace collect --process-id 12345 --providers Microsoft-DotNETCore-SampleProfiler

# Trace'i analiz et
dotnet-trace report trace.nettrace topN
8. Gerçek Dünya Performans Analizi Senaryosu
Senaryo: E-ticaret sipariş sayfası 3 saniyede yükleniyor. Kullanıcılar şikayetçi.
Adım 1: Trace'i İncele
text
Root: GET /api/order/123 (3200ms)
├── OrderService.GetOrder (150ms)
├── CustomerService.GetCustomer (200ms)
├── ProductService.GetItems (2800ms)  ← ŞÜPHELİ
│   ├── DB.GetProduct (20ms) × 100 kez = 2000ms  ← N+1!
│   └── HTTP.GetImage (8ms) × 100 kez = 800ms
└── PaymentService.GetStatus (50ms)
Adım 2: Darboğazı Tespit Et
-
Kritik yol: ProductService (2800ms)
-
Asıl sorun: 100 kez tekrarlanan DB.GetProduct sorgusu (N+1 problemi)
-
İkincil sorun: 100 kez HTTP.GetImage çağrısı
Adım 3: Çözüm Uygula
csharp
// ❌ Önce (N+1)
foreach (var item in order.Items)
{
    var product = await _db.Products.FindAsync(item.ProductId);  // 100 kez
}

// ✅ Sonra (Tek sorgu)
var productIds = order.Items.Select(i => i.ProductId).ToList();
var products = await _db.Products
    .Where(p => productIds.Contains(p.Id))
    .ToDictionaryAsync(p => p.Id);  // 1 kez

// ✅ Görselleri toplu al
var images = await _imageService.GetBatchAsync(productIds);  // 1 kez
Adım 4: Sonucu Doğrula
text
Root: GET /api/order/123 (450ms)  ← 7x iyileşme!
├── OrderService.GetOrder (150ms)
├── CustomerService.GetCustomer (200ms)
├── ProductService.GetItems (150ms)  ← 2800ms → 150ms
└── PaymentService.GetStatus (50ms)
9. En İyi Pratikler
| Pratik | Açıklama |
|---|---|
| Tail-Based Sampling Kullanın | Yavaş ve hatalı trace'leri asla kaçırmayın. |
| Anlamlı Span İsimleri | DB.GetProduct gibi; Span1 gibi değil. |
| Kritik Yolu Analiz Edin | Paralel dallar arasında en uzun olanı bulun. |
| N+1 Sorgularını Tespit Edin | Aynı parent altında tekrarlayan DB span'lerini izleyin. |
| Gap Analizi Yapın | Child span'ler arasındaki boşlukları araştırın. |
| Self-Time Hesaplayın | Span'in kendi işlem süresini ölçün. |
| Baseline Oluşturun | Normal performansı ölçün; sapmaları tespit edin. |
| Alerting Kurun | p99 latency eşiği aşıldığında uyarı gönderin. |
| Trace'leri Loglarla İlişkilendirin | trace_id ile log-trace korelasyonu sağlayın. |
10. Trace'ten Aksiyona: Optimizasyon Döngüsü
text
1. Ölç (Trace Topla)
      ↓
2. Analiz Et (Kritik Yol, Darboğaz)
      ↓
3. Optimize Et (N+1, Cache, Parallel)
      ↓
4. Doğrula (Yeni Trace ile Karşılaştır)
      ↓
5. İzle (Sürekli Monitoring)
      ↓
   (1'e dön)
Sonuç
Distributed Tracing, mikroservis mimarisinde performans analizini tahminden bilime dönüştürür. Trace ve span yapıları sayesinde bir isteğin tüm yolculuğunu görür; critical path analizi ile asıl darboğazı tespit eder; self-time ve gap analizi ile yavaşlığın kaynağını bulur; N+1 sorgu tespiti ile veritabanı problemlerini ortaya çıkarırsınız. Tail-based sampling ile yavaş trace'leri asla kaçırmaz; OpenTelemetry ve Jaeger/Grafana Tempo ile bu verileri görselleştirirsiniz. Unutmayın: Performans optimizasyonu, ölçmeden yapılmaz. Distributed Tracing, ölçümün en güçlü aracıdır; onu doğru kullanan ekipler, sorunları kullanıcılar fark etmeden çözer.