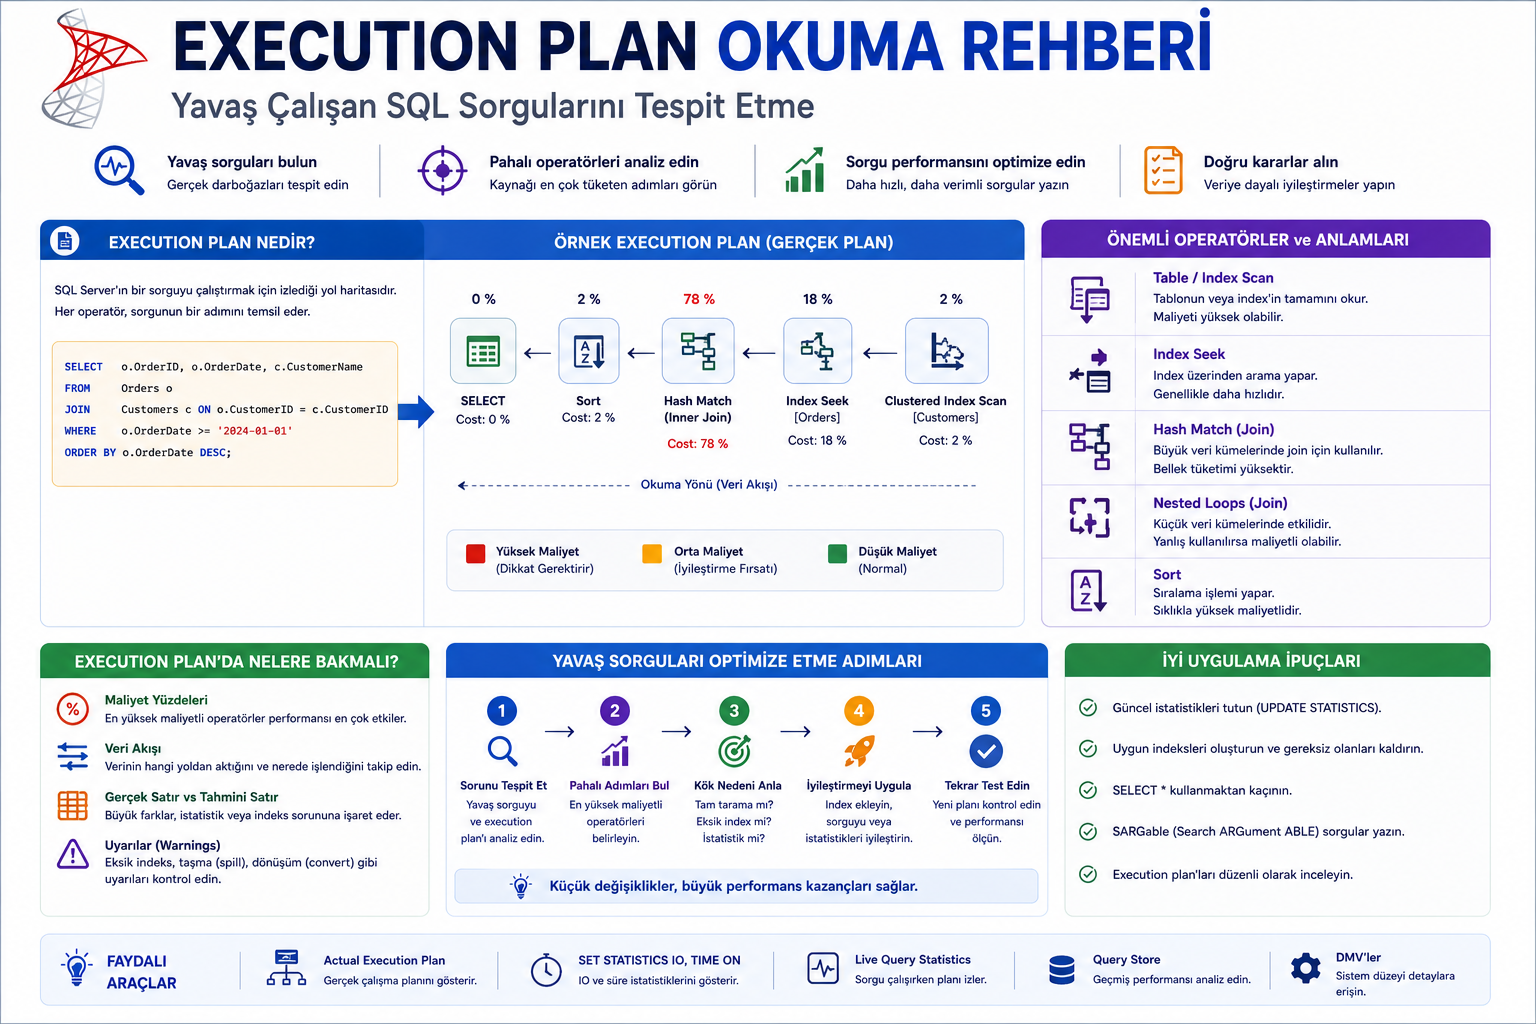
Execution Plan Okuma Rehberi: Yavaş Çalışan SQL Sorgularını Tespit Etme
Bir sorgu yavaş çalıştığında, ilk yapmanız gereken şey Execution Plan (Yürütme Planı)'nı incelemektir. Execution plan, SQL Server'ın sorgunuzu çalıştırmak için izlediği yol haritasıdır. Hangi tablolara hangi sırayla erişildiğini, hangi index'lerin kullanıldığını, hangi operatörlerin ne kadar maliyetli olduğunu ve verilerin nasıl birleştirildiğini (join) gösterir. Bu yazıda, SQL Server Management Studio (SSMS) üzerinden execution plan'ları nasıl okuyacağınızı, en pahalı operatörleri nasıl tespit edeceğinizi ve sorgularınızı nasıl optimize edeceğinizi adım adım ele alacağız.
1. Execution Plan Türleri
-
Estimated Execution Plan (Tahmini Yürütme Planı): Sorgu çalıştırılmadan önce SQL Server'ın istatistiklere (statistics) dayanarak oluşturduğu plandır. Hızlıdır ancak gerçek çalışma zamanı maliyetlerini (I/O, CPU, memory) yansıtmaz.
-
Actual Execution Plan (Gerçek Yürütme Planı): Sorgu çalıştırıldıktan sonra, gerçek çalışma istatistikleriyle birlikte elde edilen plandır. En doğru ve kullanışlı olanıdır. SSMS'de
Include Actual Execution Plan(Ctrl+M) seçeneği ile aktifleştirilir.
2. Execution Plan Nasıl Okunur? (Akış Yönü)
Execution plan, sağdan sola ve yukarıdan aşağıya doğru okunur. Planın en sağındaki operatör, sorgunun ilk adımını (verinin okunduğu tablo veya index) temsil eder. Sola doğru ilerledikçe, veriler birleştirilir (join), filtrelenir (filter), sıralanır (sort) ve son olarak sorgu sonucu (SELECT) ekrana gelir.
3. Operatör Maliyetlerini Anlama
Her operatör, toplam maliyetin yüzdesel olarak ne kadarını tükettiğini gösterir. Bu yüzde, operatörün üzerine geldiğinizde tooltip'te veya özellikler (properties) penceresinde görünür.
-
Cost (Maliyet): SQL Server'ın bir operatörü çalıştırmak için tahmin ettiği kaynak maliyetidir (I/O + CPU). %100'e kadar toplanır.
-
Subtree Cost (Alt Ağaç Maliyeti): O operatör ve altındaki tüm operatörlerin toplam maliyetidir. Bir operatörün Subtree Cost'u yüksekse, o operatör ve altındaki tüm işlemler optimize edilmelidir.
Püf Noktası: En yüksek maliyetli operatörü bulmak için plana bakın. İlk olarak en yüksek yüzdeye sahip operatörü optimize etmeye çalışın. Genellikle bu bir Table Scan, Clustered Index Scan veya Key Lookup'tur.
4. En Yaygın (ve Pahalı) Operatörler ve Çözümleri
| Operatör | Açıklama | Performans Etkisi | Çözüm / Optimizasyon |
|---|---|---|---|
| Table Scan | Tablonun tamamı taranır. Index yok veya kullanılamıyor. | 🚨 Çok Yüksek (Tüm veri okunur) | Tabloya uygun bir index ekleyin (WHERE veya JOIN sütunlarına). |
| Clustered Index Scan | Clustered index'in tamamı taranır (aslında Table Scan ile aynıdır, ancak clustered index üzerinde). | 🚨 Çok Yüksek | Sorguyu daraltacak bir non-clustered index oluşturun veya mevcut index'i kapsayıcı (covering) hale getirin. |
| Index Scan | Non-clustered index'in tamamı taranır. | 🟡 Orta-Yüksek | Daha dar bir sorgu yazın veya index'i filtreli (filtered) hale getirin. |
| Index Seek | Index üzerinde doğrudan arama yapar. | 🟢 Düşük (İdeal) | Zaten doğru index kullanılıyor. |
| Key Lookup (Bookmark Lookup) | Non-clustered index'te bulunan satır bulucu (pointer) ile veri sayfasına gidilir ve sorguda istenen diğer sütunlar alınır. | 🟡 Orta-Yüksek (Her satır için ek I/O) | Covering Index oluşturun: INCLUDE ile sorgudaki tüm sütunları index'e ekleyin. |
| Hash Match (Join) | İki tabloyu birleştirmek için hash tablosu kullanır. Genellikle index'siz join'lerde veya büyük tablolarda görülür. | 🟡 Orta-Yüksek | Join sütunlarına index ekleyin veya sorguyu yeniden yazın. |
| Nested Loops (Join) | İç içe döngü ile iki tabloyu birleştirir. Küçük tablo + index'li büyük tablo için idealdir. | 🟢 Düşük (Eğer doğru index varsa) | Zaten iyi, ancak iç tabloda arama yapmak için index olduğundan emin olun. |
| Sort | Verileri ORDER BY veya GROUP BY için sıralar. Büyük veri kümelerinde maliyetli olabilir. |
🟡 Orta | Sıralama işlemini index üzerinden karşılamaya çalışın. ORDER BY sütununu index anahtarının sonuna ekleyin. |
| RID Lookup | Heap tablosunda (clustered index'siz) satır bulucu (RID) ile veri sayfasına gidilir. | 🟡 Orta | Tabloyu clustered index'li hale getirin veya covering index oluşturun. |
5. Execution Plan'da Dikkat Edilmesi Gereken Uyarılar
-
Missing Index Hints (Eksik Index Önerileri): SSMS, planın üst kısmında yeşil bir metinle "Missing Index" önerisi sunabilir. Bu öneriler genellikle doğru ve faydalıdır, ancak her öneriyi uygulamak doğru olmayabilir. Özellikle çok sayıda yazma işlemi olan tablolarda dikkatli olun.
-
Warning (Uyarı) Simgeleri: Plan üzerinde sarı üçgen veya kırmızı daire şeklinde uyarı simgeleri olabilir. Bunların üzerine gelerek hangi sorunun yaşandığını öğrenin (ör.
CONVERT_IMPLICIT- veri tipi dönüşümü,NO JOIN PREDICATE- join koşulu eksik). -
Data Type Conversion (Veri Tipi Dönüşümü):
WHEREkoşulunda veyaJOINsütununda veri tipi uyuşmazlığı varsa (ör.VARCHARileNVARCHARkarşılaştırması), SQL Server bu sütundaki index'i kullanamaz ve Table Scan yapar. Plan'daCONVERT_IMPLICIToperatörünü arayın.
6. Execution Plan Analizine Kullanılabilecek Araçlar
-
SQL Server Management Studio (SSMS): En temel ve en güçlü araçtır. Planı grafiksel olarak gösterir.
-
Database Engine Tuning Advisor (DTA): SSMS içinde bulunan bu araç, execution plan'ı analiz ederek size index, istatistik veya bölümlendirme (partitioning) önerilerinde bulunabilir.
-
Query Store: SQL Server 2016+ ile gelen bu özellik, sorgu performansını tarihsel olarak takip eder, plan değişikliklerini izler ve geri plan döndürme (force plan) olanağı sunar.
-
Azure Data Studio: SSMS'in hafif, cross-platform alternatifidir. Execution plan görselleştirmesi sunar (ancak SSMS kadar detaylı değildir).
7. Gerçek Dünya Örnek Analizi
Yavaş Sorgu: "20.000 adet ürünü olan bir e-ticaret sitesinde, 1 Ocak 2023 ile 31 Aralık 2023 arasındaki siparişleri getiren sorgu 5 saniye sürüyor."
Execution Plan İncelemesi:
-
Actual Execution Plan alınır.
-
Planın sağında bir
Clustered Index Scan(veyaTable Scan) operatörü görülür, maliyeti %70'tir. -
Operatörün üzerine gelindiğinde,
Orderstablosunun tüm satırlarını okuduğu görülür (Estimated Rows: 1 Milyon). -
WHEREkoşulundaOrderDatesütunu kullanılıyor, ancak bu sütunda index yok.
Optimizasyon Adımları:
-
OrderDatesütununa non-clustered index oluşturulur. -
Plan tekrar alındığında,
Clustered Index ScanyerineIndex Seek (Non-Clustered)operatörü gelir. -
Ancak şimdi de
Key Lookupoperatörü belirir (%40 maliyetle). -
Sorgu
SELECT OrderId, CustomerName, OrderDate, TotalAmountgibi sütunlar getiriyor. -
Key Lookup'u ortadan kaldırmak içinINCLUDEile covering index oluşturulur:sql
CREATE NONCLUSTERED INDEX IX_Orders_OrderDate
ON Orders (OrderDate)
INCLUDE (OrderId, CustomerName, TotalAmount);
-
Plan tekrar alındığında, artık sadece
Index Seek(non-clustered) operatörü kalır ve toplam maliyet %5'in altına düşer. Sorgu 50 ms'de tamamlanır.
8. .NET / EF Core ile Execution Plan Analizi
EF Core, SQL Server ile çalışırken yavaş sorguları tespit etmenin birkaç yolu vardır:
-
Logging (Günlük Kaydı): EF Core, sorguları ve bunların execution plan'larını loglayabilir.
optionsBuilder.LogTo(Console.WriteLine)ile tüm SQL sorgularını ve execution plan'larını konsola yazdırabilirsiniz. -
ToQueryString(): Bir LINQ sorgusunun hangi SQL'e dönüşeceğini görmek için.ToQueryString()metodu kullanılabilir. Bu SQL'i SSMS'de çalıştırarak execution plan'ını inceleyin. -
FromSqlRaw/FromSqlInterpolated: Ham SQL sorguları yazarken, bu sorguları da execution plan ile test edin. -
Application Insights veya SQL Server Profiler: Production ortamında, yavaş sorguları tespit etmek ve execution plan'larını yakalamak için SQL Server Profiler veya Azure Application Insights kullanılabilir.
Sonuç:
Execution Plan okuma becerisi, bir veritabanı veya .NET geliştiricisinin en değerli yeteneklerinden biridir. Sorgu performansının nasıl optimize edileceğine dair en doğru kararları, plan'ı okuyarak verebilirsiniz. Unutmayın:
-
Sağdan sola okuyun.
-
En pahalı operatör en soldaki değil, en yüksek yüzdeye sahip olanıdır.
-
Key Lookup ve Table Scan en büyük düşmanlarınızdır. (Covering index ile çözülür.)
-
İstatistikler (Statistics) güncel değilse, SQL Server yanlış plan seçebilir. Düzenli olarak istatistik güncellemesi yapın.
-
Her zaman Actual Execution Plan ile çalışın.