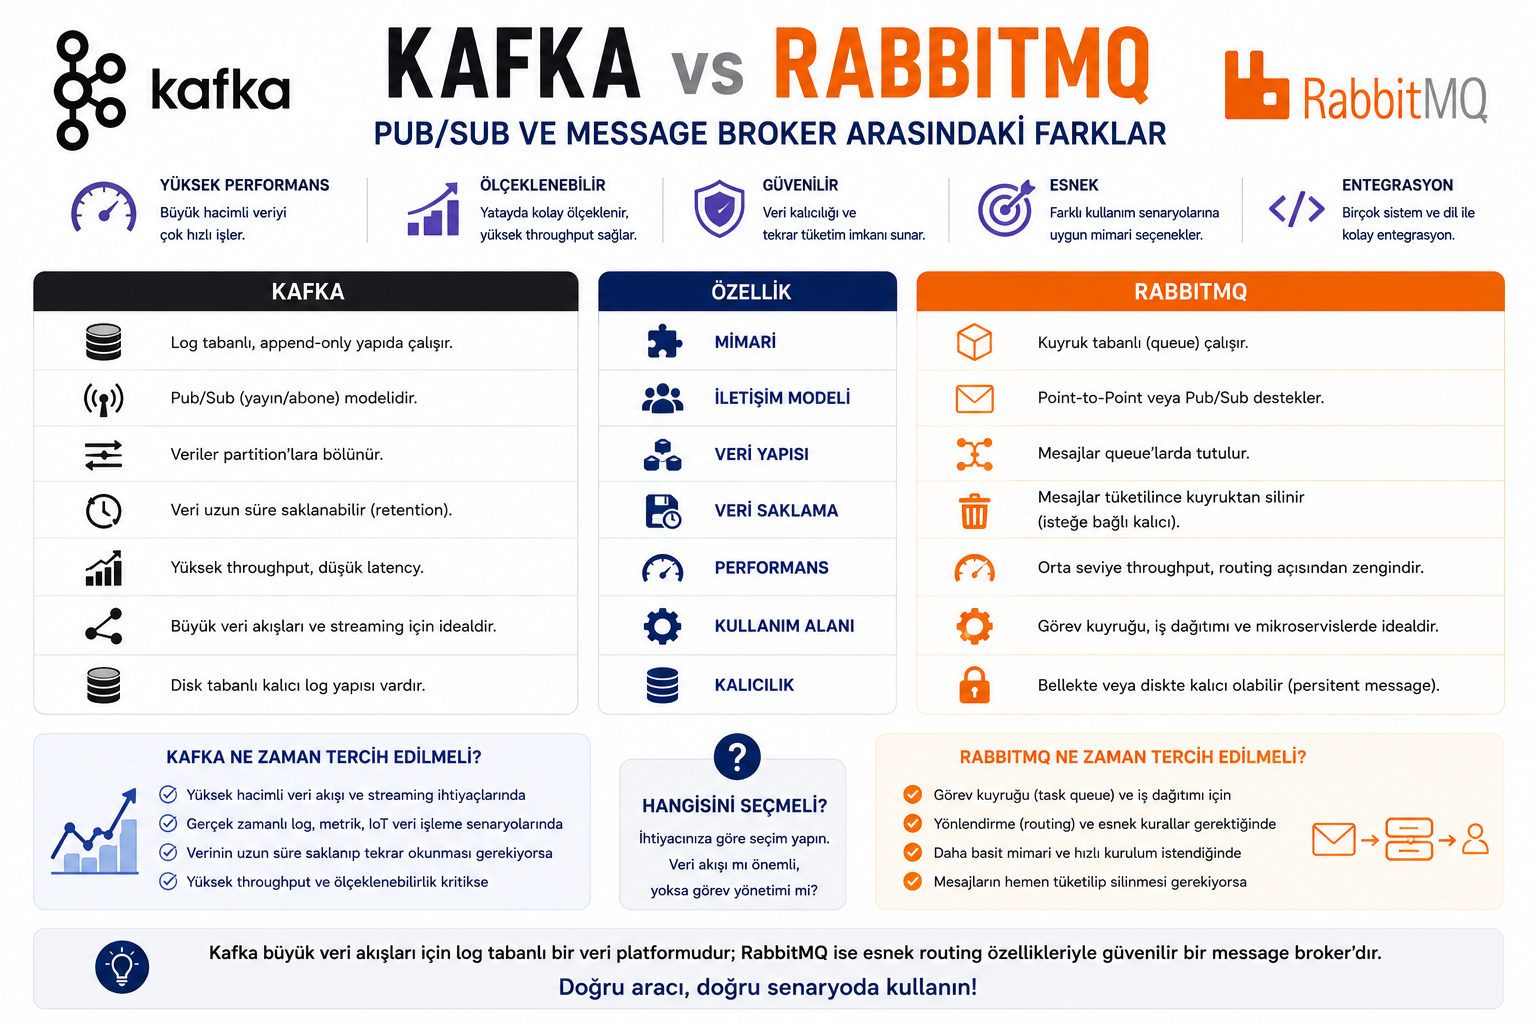
Kafka vs. RabbitMQ: Pub/Sub ve Message Broker Arasındaki Farklar
Message broker'lar (mesaj aracıları), dağıtık sistemlerin iletişim omurgasını oluşturur. Ancak, tüm broker'lar aynı amaç için tasarlanmamıştır. RabbitMQ ve Apache Kafka, bu alandaki en popüler iki açık kaynak çözümdür, ancak felsefeleri, mimarileri ve kullanım senaryoları tamamen farklıdır.
-
RabbitMQ: Geleneksel bir message broker'dır. Kuyruk tabanlı, istek/yanıt (request/response) veya iş kuyruğu (task queue) desenleri için idealdir. Mesajlar tüketildikten sonra kuyruktan silinir.
-
Apache Kafka: Dağıtık bir event streaming platform'udur. Log tabanlı, yüksek verimli, veri akışı (data pipeline) ve gerçek zamanlı analitik için tasarlanmıştır. Mesajlar, belirli bir süre (retention policy) boyunca saklanır ve tüketiciler istedikleri zaman okuyabilir.
Bu yazıda, bu iki güçlü aracı mimari, veri modeli, performans, ölçeklenebilirlik ve kullanım senaryoları açısından karşılaştıracak, hangi projede hangi aracı seçmeniz gerektiğine dair net bir rehber sunacağız.
1. Hızlı Karşılaştırma Tablosu
| Kriter | RabbitMQ | Apache Kafka |
|---|---|---|
| Temel Felsefe | Mesaj kuyruğu (Queue) | Dağıtık log (Commit Log) |
| Veri Modeli | Kuyruk (Mesaj tüketildikten sonra silinir) | Topic (Mesajlar retention süresince saklanır) |
| Tüketim Modeli | Push (Competing Consumers) | Pull (Consumer Group ile offset yönetimi) |
| Mesaj Sıralaması | Tek bir kuyrukta FIFO | Aynı partition içinde FIFO |
| Performans | Düşük gecikme (low latency), orta verim | Yüksek gecikme (biraz daha yüksek), çok yüksek verim (milyon/saniye) |
| Ölçeklenebilirlik | Yatay ölçekleme (cluster) | Yatay ölçekleme (partition) |
| Mesaj Kalıcılığı | Durable queue + persistent message | Varsayılan olarak diskte kalıcı (retention) |
| Desteklenen Desenler | Pub/Sub, RPC, Work Queue, Event Sourcing (sınırlı) | Pub/Sub, Event Sourcing, Stream Processing, CDC |
| Kullanım Senaryosu | İş kuyruğu, mikroservis iletişimi, RPC | Veri akışı, log toplama, event-driven mimari, CDC |
| .NET Entegrasyonu | MassTransit, RabbitMQ.Client | Confluent.Kafka, MassTransit |
2. Mimariler ve Çalışma Mantığı
A. RabbitMQ (Kuyruk Tabanlı)
RabbitMQ, AMQP protokolü üzerinde çalışır. Üretici (producer), mesajı bir exchange'e gönderir. Exchange, routing kurallarına (direct, fanout, topic, headers) göre mesajı bir veya daha fazla kuyruğa (queue) yönlendirir. Tüketici (consumer), kuyruktaki mesajları alır ve işler. Mesaj bir kez tüketildikten sonra kuyruktan silinir (onay / ack ile).
-
Push Model: RabbitMQ, mesajları tüketiciye "iter" (push). Tüketici pasiftir; mesaj gelince işler.
-
Competing Consumers (Rakip Tüketici): Aynı kuyruktan birden fazla tüketici mesaj alabilir; her mesaj sadece bir tüketiciye gider (iş yükü dağıtımı).
B. Apache Kafka (Log Tabanlı)
Kafka, bir commit log (işlem günlüğü) olarak tasarlanmıştır. Mesajlar, topic'lere yazılır ve her topic, birden fazla partition'a (bölüm) bölünür. Her mesaj, partition içinde monoton olarak artan bir offset (sıra numarası) alır.
-
Pull Model: Tüketiciler (consumer), Kafka'dan mesajları "çeker" (pull). Tüketici, hangi offset'ten itibaren okuyacağını kendisi belirler.
-
Consumer Group: Aynı consumer group içindeki tüketiciler, partition'ları paylaşarak (her partition bir tüketiciye atanır) yatay ölçeklenir.
-
Mesaj Saklama: Kafka, mesajları belirlenen bir süre (retention) boyunca diskte saklar (varsayılan 7 gün). Tüketici, istediği zaman geçmiş mesajları (replay) okuyabilir.
3. Detaylı Karşılaştırma
A. Mesaj Tüketim Modeli (Push vs Pull)
-
RabbitMQ (Push): Mesajlar tüketiciye anında iletilir. Düşük gecikme (low latency) gerektiren senaryolar için idealdir. Ancak, tüketici yavaşsa veya çökerse, mesajlar kuyrukta birikir ve sistem tıkanabilir.
-
Kafka (Pull): Tüketici, mesajları kendi hızında çeker. Bu, tüketici hızının üreticiden bağımsız olmasını sağlar. Kafka, tüketicinin hızına uyum sağlar (backpressure yoktur). Ancak, boşta kalma durumunda tüketici sürekli polling (yoklama) yapmak zorundadır.
B. Mesaj Sıralaması (Ordering)
-
RabbitMQ: Tek bir kuyrukta mesajlar FIFO (First-In-First-Out) sırasıyla işlenir. Ancak, birden fazla tüketici aynı kuyruktan mesaj alıyorsa, sıralama garanti edilmez.
-
Kafka: Aynı partition içinde mesajlar kesinlikle sıralıdır. Kafka, partition başına sıralama garantisi verir. İş sıralaması önemliyse, mesajlar aynı anahtarla (key) aynı partition'a gönderilmelidir.
C. Performans ve Verim
-
RabbitMQ: Düşük gecikme (milisaniye altı), ancak yüksek verim (throughput) sınırlıdır. Saniyede yaklaşık 10.000-20.000 mesaj ile iyi çalışır.
-
Kafka: Daha yüksek gecikme (milisaniye seviyesinde), ancak inanılmaz verim: saniyede milyonlarca mesaj işleyebilir. Bunu, disk sıralı yazma (sequential writes), sıfır kopyalama (zero-copy) ve batched (toplu) işlemler ile başarır.
D. Mesaj Kalıcılığı ve Tarihsel Veri
-
RabbitMQ: Mesajlar tüketildikten sonra silinir. Eski mesajlara erişim mümkün değildir (kalıcı mesajlar sunucu yeniden başlatılsa bile dayanıklıdır, ancak tüketildikten sonra kaybolur).
-
Kafka: Mesajlar, retention süresi boyunca diskte saklanır. Bu, tüketicilerin geçmişe yönelik analiz yapmasına veya hata durumunda mesajları yeniden işlemesine (replay) olanak tanır.
E. Yönetim ve Operasyon
-
RabbitMQ: Yönetim arayüzü (UI) güçlüdür, kuyrukları, exchange'leri ve binding'leri görsel olarak yönetmek kolaydır. Kurulumu basittir.
-
Kafka: Yönetimi daha zordur. Cluster kurulumu, partition yönetimi, broker ayarları daha karmaşıktır. Ancak, son yıllarda araçlar (Kafka UI, Confluent Control Center) gelişmiştir.
4. .NET ile Entegrasyon
RabbitMQ ile .NET:
-
RabbitMQ.Client: Ham istemci, düşük seviye kontrol sağlar.
-
MassTransit: RabbitMQ üzerinde yüksek seviye soyutlama, CQRS, MediatR, Outbox desteği.
-
EasyNetQ: Basitleştirilmiş, convention-based API.
Kafka ile .NET:
-
Confluent.Kafka: En yaygın, resmi .NET istemcisi. Apache Kafka 2.x ve 3.x ile uyumlu.
-
MassTransit: Kafka desteği de sunar.
-
Streamiz.Kafka.Net: Kafka Streams API'nin .NET uyarlaması.
csharp
// Confluent.Kafka ile Producer
var config = new ProducerConfig { BootstrapServers = "localhost:9092" };
using var producer = new ProducerBuilder<string, string>(config).Build();
await producer.ProduceAsync("my-topic", new Message<string, string> { Key = "key1", Value = "Hello Kafka!" });
csharp
// MassTransit ile RabbitMQ Producer
var bus = Bus.Factory.CreateUsingRabbitMq(cfg => {
    cfg.Host("localhost", "/", h => {
        h.Username("guest");
        h.Password("guest");
    });
});
await bus.Publish(new OrderCreated { OrderId = 123 });
5. Kullanım Senaryoları: Ne Zaman Hangisi?
RabbitMQ'yu Seçin (Kuyruk / Message Broker):
-
İş Kuyruğu (Task Queue): Uzun süren, arka planda yapılacak işler (e-posta gönderme, PDF oluşturma, image processing).
-
Mikroservisler Arası RPC (Request-Reply): Servisler arası senkron iletişim (ör. OrderService -> PaymentService çağrısı).
-
Olay Tabanlı (Event-Driven) Basit İletişim: Servis sayısı az ve mesaj hacmi düşükse.
-
Düşük Gecikme (Low Latency) Gerekiyorsa: Milisaniye altı tepki süresi kritikse.
-
Ekip RabbitMQ'ya Aşinaysa ve kurulum/operasyon kolaylığı isteniyorsa.
Kafka'yı Seçin (Event Streaming / Log Tabanlı):
-
Yüksek Verim (High Throughput) Gerekiyorsa: Saniyede milyonlarca mesaj işlenmesi gerekiyorsa.
-
Geçmiş Veriye Erişim / Replay İhtiyacı: Hata durumunda mesajları yeniden işleme veya veri analitiği yapma.
-
Long-Term Storage (Uzun Süreli Saklama): Mesajların günlerce veya haftalarca saklanması gerekiyorsa.
-
Event Sourcing ve CDC (Change Data Capture): Veritabanı değişikliklerini akış olarak yakalamak.
-
Stream Processing: Gerçek zamanlı veri analitiği, windowing, aggregasyon (Kafka Streams, kSQL).
-
Çok Sayıda Tüketici (Multiple Consumers): Farklı uygulamalar aynı veri akışını farklı hızlarda tüketiyorsa.
Hibrit Yaklaşım:
Çoğu büyük sistem, her iki aracı da kullanır:
-
Kafka: Veritabanı CDC, olay kaynağı (event store), veri akışı (data pipeline), analitik.
-
RabbitMQ: Servisler arası senkron iletişim, iş kuyrukları, RPC, kısa ömürlü mesajlar.
6. Sık Yapılan Hatalar
| Hata | Çözüm |
|---|---|
| RabbitMQ'yu veri akışı (data pipeline) için kullanmak | RabbitMQ, mesaj tüketildikten sonra siler, replay mümkün değildir. |
| Kafka'yı iş kuyruğu olarak kullanmak | Kafka'da mesaj tüketildikten sonra silinmez; offset manuel yönetilmelidir. |
| Kafka'da mesaj sıralamasına güvenmek | Sadece aynı partition içinde sıralama garantisi vardır. |
| RabbitMQ'yu çok yüksek verim için zorlamak | RabbitMQ, yüksek verim için tasarlanmamıştır; ölçeklenebilirlik sınırlıdır. |
| Kafka'yı düşük gecikme için kullanmak | Kafka daha yüksek gecikmeye sahiptir; çok hızlı tepki gerekiyorsa RabbitMQ daha uygundur. |
Sonuç:
RabbitMQ ve Kafka, birbirinin rakibi değil, tamamlayıcısıdır. RabbitMQ, esnek routing yetenekleri ve düşük gecikme ile geleneksel mesaj kuyruğu ihtiyaçları için idealdir. Kafka ise yüksek verim, geçmiş veriye erişim ve event streaming senaryoları için tasarlanmıştır. Doğru seçim, uygulamanızın gereksinimlerine bağlıdır: eğer iş kuyrukları ve servisler arası iletişim varsa RabbitMQ; yüksek hacimli veri akışı, CDC veya event sourcing varsa Kafka tercih edilmelidir. Her iki aracı da kullanmaktan çekinmeyin; zaten büyük sistemlerde genellikle ikisi bir arada bulunur.