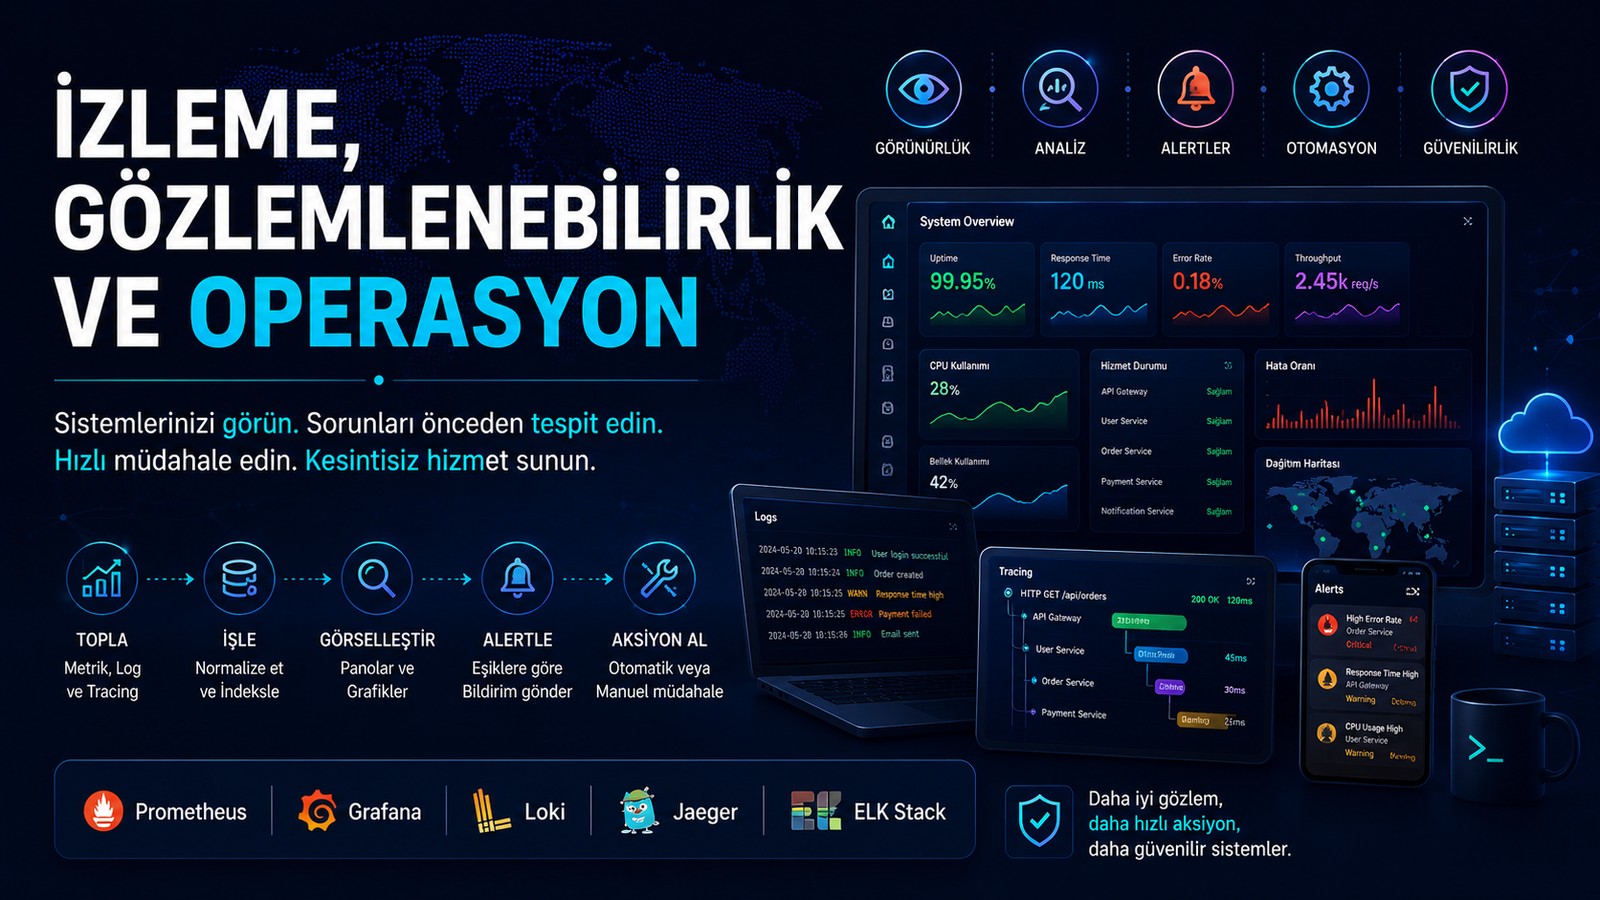
İzleme, Gözlemlenebilirlik ve Operasyon: Modern Sistemleri Anlamak ve Yönetmek
Dağıtık sistemler, mikroservisler, container'lar ve serverless ortamlar, uygulamaların karmaşıklığını katlanarak artırmıştır. Bu sistemlerin sağlıklı, performanslı ve güvenilir bir şekilde çalışmasını sağlamak, sadece "çalışıyor mu?" sorusunu değil, "neden çalışmıyor?" ve "nasıl çalışıyor?" sorularını da yanıtlayabilmeyi gerektirir. İşte bu noktada izleme (monitoring), gözlemlenebilirlik (observability) ve operasyon kavramları devreye girer. Bu yazıda, bu üç ayağın temel prensiplerini, araçlarını ve .NET ekosistemindeki uygulamalarını detaylıca ele alacağız.
1. Monitoring (İzleme) vs. Observability (Gözlemlenebilirlik): Temel Fark
-
Monitoring (İzleme): Önceden tanımlanmış metrikleri (CPU, bellek, hata oranları) toplamak ve belirli eşik değerleri (threshold) aşıldığında uyarı (alert) göndermektir. "Sistem çalışıyor mu?" sorusunu yanıtlar.
-
Observability (Gözlemlenebilirlik): Sistemin iç durumunu, dışarıdan toplanan log'lar, metrikler ve izler (traces) aracılığıyla anlama yeteneğidir. "Sistem neden böyle çalışıyor?" ve "Bu hatanın kaynağı ne?" sorularını yanıtlamayı hedefler.
Observability'nin Üç Sütunu (The Three Pillars of Observability):
| Sütun | Açıklama | .NET Araçları |
|---|---|---|
| Logs (Günlükler) | Yapılandırılmış veya yapılandırılmamış, zaman damgalı olay kayıtları. | Serilog, NLog, Microsoft.Extensions.Logging |
| Metrics (Metrikler) | Zaman içinde toplanan sayısal veriler (ör. istek sayısı, yanıt süresi). | Prometheus (OpenTelemetry), Application Insights |
| Traces (Dağıtık İzler) | Bir isteğin servisler arasındaki yolculuğunu (end-to-end) izleme. | OpenTelemetry, Jaeger, Zipkin, Azure Application Insights |
2. Log Yönetimi (Logging)
Log'lar, uygulamanızın davranışını anlamanın en temel yoludur. Modern log yönetimi, yapılandırılmış (structured) log'ları ve merkezi toplamayı gerektirir.
A. Yapılandırılmış Loglama (Structured Logging)
JSON formatında, sorgulanabilir ve analiz edilebilir log'lar oluşturmaktır.
csharp
// Serilog ile yapılandırılmış loglama
var logger = Log.ForContext<User>(user);
logger.Information("Sipariş oluşturuldu {OrderId} için {CustomerName}",
    order.Id, order.CustomerName);
// JSON çıktısı: {"OrderId": 123, "CustomerName": "Ahmet", "Message": "Sipariş oluşturuldu..."}
B. Log Seviyeleri (Log Levels)
-
Trace: En detaylı, geliştirme/debug için.
-
Debug: Geliştirme ve test için faydalı bilgiler.
-
Information: Normal çalışma akışı (ör. "Kullanıcı giriş yaptı").
-
Warning: Beklenen, ancak ele alınması gereken durumlar (ör. "Düşük stok").
-
Error: Hata durumları (try-catch'te logla).
-
Critical: Sistem çökmesi, acil müdahale gerektiren durumlar.
C. Merkezi Log Toplama (Centralized Log Aggregation)
Log'ları, Elasticsearch, Azure Log Analytics, Datadog veya Loki gibi merkezi bir sisteme gönderin.
csharp
// Serilog ile Elasticsearch'e gönderme
Log.Logger = new LoggerConfiguration()
    .WriteTo.Elasticsearch(new ElasticsearchSinkOptions(new Uri("http://localhost:9200")))
    .CreateLogger();
3. Metrik Toplama ve Uyarılar (Metrics & Alerting)
Metrikler, sistemin performansını ve sağlığını sayısal olarak izlemenizi sağlar. .NET'te metrik toplamak için standart OpenTelemetry kullanımı yaygınlaşmaktadır.
A. OpenTelemetry ile Metrik Toplama
OpenTelemetry, observability verilerini (log, metric, trace) toplamak, işlemek ve dışa aktarmak için açık kaynaklı, sağlayıcıdan bağımsız bir standarttır.
csharp
// OpenTelemetry ile metrik toplama
builder.Services.AddOpenTelemetry()
    .WithMetrics(metrics => metrics
        .AddAspNetCoreInstrumentation() // ASP.NET Core metrikleri
        .AddHttpClientInstrumentation() // HttpClient metrikleri
        .AddRuntimeInstrumentation()    // .NET Runtime metrikleri (GC, ThreadPool)
        .AddPrometheusExporter()        // Prometheus'a gönder
    );
B. Prometheus ve Grafana
Prometheus, metrik toplama ve sorgulama (PromQL) için, Grafana ise görselleştirme (dashboard) ve uyarı yönetimi için en popüler açık kaynak kombinasyondur.
C. Sağlık Kontrolleri (Health Checks)
Uygulamanızın bağımlılıklarının (veritabanı, harici API, cache) sağlıklı olup olmadığını kontrol eden endpoint'lerdir. Kubernetes ve load balancer'lar tarafından kullanılır.
csharp
// Health Checks ekleme
builder.Services.AddHealthChecks()
    .AddDbContextCheck<AppDbContext>()
    .AddUrlGroup(new Uri("https://api.example.com"), "External API");

// Health Check endpoint'i
app.MapHealthChecks("/health", new HealthCheckOptions
{
    ResponseWriter = UIResponseWriter.WriteHealthCheckUIResponse
});
4. Dağıtık İzleme (Distributed Tracing)
Mikroservislerde bir istek, birden fazla servisten geçer. Dağıtık izleme, bu isteğin tüm servisler arasındaki yolculuğunu (end-to-end) görmenizi sağlar.
A. Trace, Span ve Baggage
-
Trace: Bir isteğin tüm yolculuğu.
-
Span: Trace içindeki her bir servis çağrısı (ör. API çağrısı, DB sorgusu).
-
Baggage (Metadata): Trace boyunca taşınan ek bilgiler.
B. .NET ile OpenTelemetry Tracing
csharp
// OpenTelemetry ile tracing
builder.Services.AddOpenTelemetry()
    .WithTracing(tracing => tracing
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddSqlClientInstrumentation()
        .AddJaegerExporter(options =>
        {
            options.AgentHost = "localhost";
            options.AgentPort = 6831;
        })
    );
C. W3C Trace Context
W3C standardı, HTTP header'ları ile trace bilgilerinin taşınmasını sağlar. traceparent header'ı, servisler arası izlemenin kesintisiz olmasını sağlar.
5. SLI, SLO ve SLA: Hizmet Seviyesi Yönetimi
-
SLI (Service Level Indicator): Hizmet kalitesini ölçen metrik (ör. yanıt süresi, hata oranı).
-
SLO (Service Level Objective): SLI için hedef değer (ör. yanıt süresi < 200ms, hata oranı < %1).
-
SLA (Service Level Agreement): Müşteri ile yapılan resmi sözleşme (ör. aylık uptime %99.9).
csharp
// SLI metrikleri örneği
// - İstek başına yanıt süresi
// - HTTP 500 hata oranı
// - Veritabanı sorgu süresi
6. Incident Yönetimi ve Operasyon
-
Incident (Olay): Hizmet kesintisi veya kalite düşüşü.
-
Incident Management: Olayları tespit etme, müdahale etme, çözme ve analiz etme süreci.
-
Runbook (Çalışma Kitabı): Bilinen sorunlar için adım adım çözüm kılavuzu.
-
On-Call: 7/24 nöbetçi ekip.
7. .NET'te Observability İçin Araçlar
| Araç | Kullanım Alanı |
|---|---|
| Serilog | Yapılandırılmış loglama |
| Application Insights | Azure'da uçtan uca izleme ve performans yönetimi |
| OpenTelemetry | Standart metrik, log ve trace toplama |
| Prometheus + Grafana | Metrik toplama, görselleştirme ve uyarılar |
| Jaeger / Zipkin | Dağıtık izleme (tracing) |
| Elasticsearch + Kibana (ELK) | Merkezi log yönetimi |
| Azure Monitor | Azure kaynakları için izleme ve uyarılar |
| Datadog / New Relic | Üçüncü parti observability platformları |
8. Observability'de En İyi Pratikler (Best Practices)
-
Standardizasyon: OpenTelemetry gibi standartları benimseyin.
-
Yapılandırılmış Loglama: JSON formatında, anlamlı alanlar içeren log'lar oluşturun.
-
Doğru Metrik Seçimi: "USE" (Utilization, Saturation, Errors) veya "RED" (Rate, Errors, Duration) yöntemlerini kullanarak kritik metrikleri belirleyin.
-
Anlamlı Uyarılar (Alerts): Uyarıları gereksiz bilgi kirliliğinden arındırın; her uyarı eyleme geçirilebilir (actionable) olmalıdır.
-
Runbook ve Dokümantasyon: Bilinen sorunlar için çözüm adımlarını belgeleyin.
-
Erken Entegrasyon: Observability'yi projenin en başında (shift-left) düşünün; sadece production değil, geliştirme ve test ortamlarında da aktif olsun.
-
Veri Gizliliği: Log'lara ve trace'lere PII (kişisel veri) koymayın; gerekirse maskeleme (masking) uygulayın.
Sonuç:
İzleme, gözlemlenebilirlik ve operasyon, modern yazılım sistemlerinin vazgeçilmez üç yapı taşıdır. Monitoring, sistemin mevcut durumunu anlamanızı; observability, karmaşık sorunları teşhis etmenizi; operasyonel mükemmellik ise bu bilgileri kullanarak sistemin güvenilir, performanslı ve sürdürülebilir olmasını sağlar.
.NET ekosistemi, bu üç alanı destekleyen güçlü araçlara (OpenTelemetry, Serilog, Application Insights, Prometheus, Grafana, Jaeger) sahiptir. Doğru strateji ve araçlarla, dağıtık sistemlerde bile sisteminizin sağlığını ve performansını net bir şekilde gözlemleyebilir, olası sorunları önceden tespit edebilir ve etkili müdahalelerde bulunabilirsiniz.