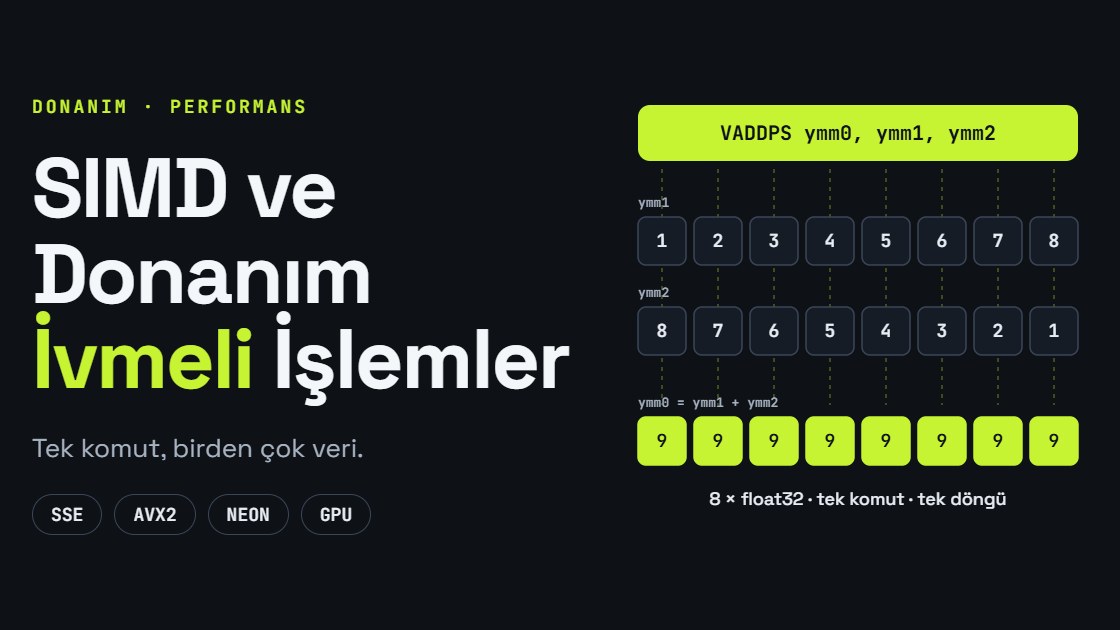
SIMD ve Donanım İvmeli İşlemler
Modern işlemciler, tek bir komutla birden fazla veri parçası üzerinde işlem yapabilen SIMD (Single Instruction, Multiple Data) uzantılarına sahiptir. Bu yetenek, özellikle sayısal hesaplama, bilimsel simülasyon, grafik, metin işleme ve veri-paralel iş yüklerinde, aynı işlemin bir buffer üzerinde tekrarlandığı senaryolarda verimliliği önemli ölçüde artırır . Ancak SIMD kodu yazmak, skaler koda göre daha karmaşıktır; bu nedenle yalnızca girdi boyutu yeterince büyükse ve kazanç ölçümle kanıtlanmışsa değerlidir .
1. .NET'te SIMD Katmanları
.NET, farklı kontrol seviyeleri ve karmaşıklık dereceleri sunan katmanlı bir SIMD API'si sağlar :
| API | Namespace | Ne Zaman Kullanılır? |
|---|---|---|
| Vector2/3/4, Matrix3x2/4x4 | System.Numerics |
Grafik ve geometri matematiği (2-4 elemanlı vektörler, matrisler, kuaterniyonlar) |
Vector<T> |
System.Numerics |
Platforma özel kontrol gerekmediğinde taşınabilir, değişken genişlikli vektörleştirme |
Vector64<T> – Vector512<T> |
System.Runtime.Intrinsics |
İnce taneli kontrol gerektiren, platformlar arası sabit genişlikli vektörleştirme. Yeni algoritmalar için önerilen başlangıç noktası |
| Donanım Intrinsic'leri | System.Runtime.Intrinsics.X86, .Arm, .Wasm |
Üst düzey API'lerin sunmadığı, kritik sıcak yollarda son performans artışı için processöre özel komutlar |
| TensorPrimitives | System.Numerics.Tensors |
Hazır, vektörleştirilmiş matematiksel işlemler (Span üzerinde çalışır, SIMD'i sizin için uygular) |
Bu katmanlar birbirine soyutlama ile bağlıdır: Vector<T>, donanımın desteklediği genişliğe kadar büyür; sabit genişlikli Vector128<T> gibi tipler ise platformdan bağımsız çalışır ve donanım intrinsic'lerine indirgenir .
2. Vector<T>: Taşınabilir Vektörleştirme
Vector<T>, çalışma zamanındaki CPU'nun desteklediği genişliğe göre boyutlanan bir vektördür. Vector<T>.Count değeri JIT derleyicisi tarafından sabit olarak kabul edilir, bu da döngülerin optimize edilmesini sağlar .
csharp
// İki diziyi eleman bazında toplama (örnekleyici)
public static double[] Add(double[] left, double[] right)
{
    double[] result = new double[left.Length];
    int i = 0;
    int lastVectorStart = left.Length - Vector<double>.Count;

    for (; i <= lastVectorStart; i += Vector<double>.Count)
    {
        Vector<double> v1 = Vector.Create(left.AsSpan(i));
        Vector<double> v2 = Vector.Create(right.AsSpan(i));
        (v1 + v2).CopyTo(result, i);
    }

    for (; i < left.Length; i++)
        result[i] = left[i] + right[i];

    return result;
}
Pratik Not: Bu tür döngüleri elle yazmak yerine, TensorPrimitives.Add gibi hazır vektörleştirilmiş metotlar tercih edilmelidir; bunlar tüm desteklenen eleman tipleri için optimize edilmiştir .
3. Sabit Genişlikli Vektörler: Vector128<T>
Vector128<T>, vektörleştirmeyi destekleyen tüm platformlarda ortak payda olduğu için yeni algoritmalar için en iyi başlangıç noktasıdır . 128 bitlik bir vektör; 16 byte, 8 short, 4 int/float veya 2 long/double tutabilir .
Vector256<T> ve Vector512<T> sırasıyla iki ve dört kat daha geniştir; ancak her donanım bu genişlikleri desteklemez .
Donanım Hızlandırma Kontrolü:
SIMD tipleri, donanım desteği olmasa bile yazılım fallback'i ile çalışır. Gerçek hızlandırmanın mevcut olup olmadığını kontrol etmek için IsHardwareAccelerated özelliği kullanılır :
csharp
if (Vector128.IsHardwareAccelerated)
{
    // SIMD yolu
}
else
{
    // Skaler fallback
}
Bu özellikler JIT tarafından sabite dönüştürülür; kullanılmayan dal elimine edilir ve çalışma zamanı maliyeti yoktur. Değerleri cache'lemeyin; ihtiyaç duyduğunuz yerde doğrudan okuyun .
4. Donanım Intrinsic'leri: Son Performans Artışı
Donanım intrinsic'leri, System.Runtime.Intrinsics.X86 (SSE, AVX, AVX-512), System.Runtime.Intrinsics.Arm (AdvSimd, SVE) ve System.Runtime.Intrinsics.Wasm altında platforma özel işlemci komutlarını doğrudan sunar . Her intrinsic, tek bir işlemci komutuna karşılık gelir .
Bu API'ler, Vector128<T> gibi vektör tipleri üzerinde çalışır ve JIT derleyicisi tarafından tanınarak ilgili makine komutlarına indirgenir .
Ne Zaman Kullanılmalı? Yalnızca üst düzey API'lerin (TensorPrimitives, Vector<T>) yetersiz kaldığı ve darboğazın ölçümle kanıtlandığı kritik sıcak yollarda. Örneğin, belirli bir bit manipülasyonu veya şifreleme komutu gerektiğinde .
5. Eleman Tipi Desteği ve Yeniden Yorumlama
Vector128<T> ve kardeşleri şu ilkel sayısal tipleri destekler: byte, sbyte, short, ushort, int, uint, long, ulong, float, double, nint, nuint .
char ve bool gibi desteklenmeyen tipler, aynı boyuttaki desteklenen bir tipe yeniden yorumlanarak vektörleştirilebilir. Cast veya As<TFrom, TTo> metotları yalnızca tipi değiştirir, bitleri değil; verinin geçerli kalması sizin sorumluluğunuzdadır (ör. bool 0 veya 1 kalmalı) .
6. En İyi Pratikler
| Pratik | Açıklama |
|---|---|
| Önce ölçün, sonra SIMD'e geçin | Kazanç yalnızca büyük girdilerde ve ölçümle doğrulandığında değerlidir |
TensorPrimitives ile başlayın |
Hazır vektörleştirilmiş metotlar, elle yazılan SIMD'den daha güvenli ve genellikle yeterlidir |
Vector128<T> ile başlayın |
Taşınabilirlik ve geniş donanım desteği için en güvenli başlangıç noktasıdır |
IsHardwareAccelerated kontrolünü doğru yapın |
JIT sabiti olduğu için maliyetsizdir; değerleri cache'lemeyin |
| Intrinsic'leri son çare olarak kullanın | Platforma özel kod, taşınabilirliği azaltır ve bakım maliyetini artırır |
Sonuç
SIMD ve donanım ivmeli işlemler, .NET'te yüksek performanslı sayısal ve veri-paralel kod yazmanın en güçlü araçlarından biridir. Vector<T> taşınabilir bir başlangıç sunarken, Vector128<T> sabit genişlikli ve platformlar arası bir temel sağlar; donanım intrinsic'leri ise kritik sıcak yollarda son performans artışını mümkün kılar. Ancak bu güç, beraberinde karmaşıklık getirir: SIMD kodu, yalnızca ölçümle doğrulanmış darboğazlarda ve girdi boyutu yeterince büyük olduğunda değerlidir. Unutmayın: En hızlı kod, en karmaşık kod değil; ölçülen, doğrulanan ve bakımı sürdürülebilir koddur.