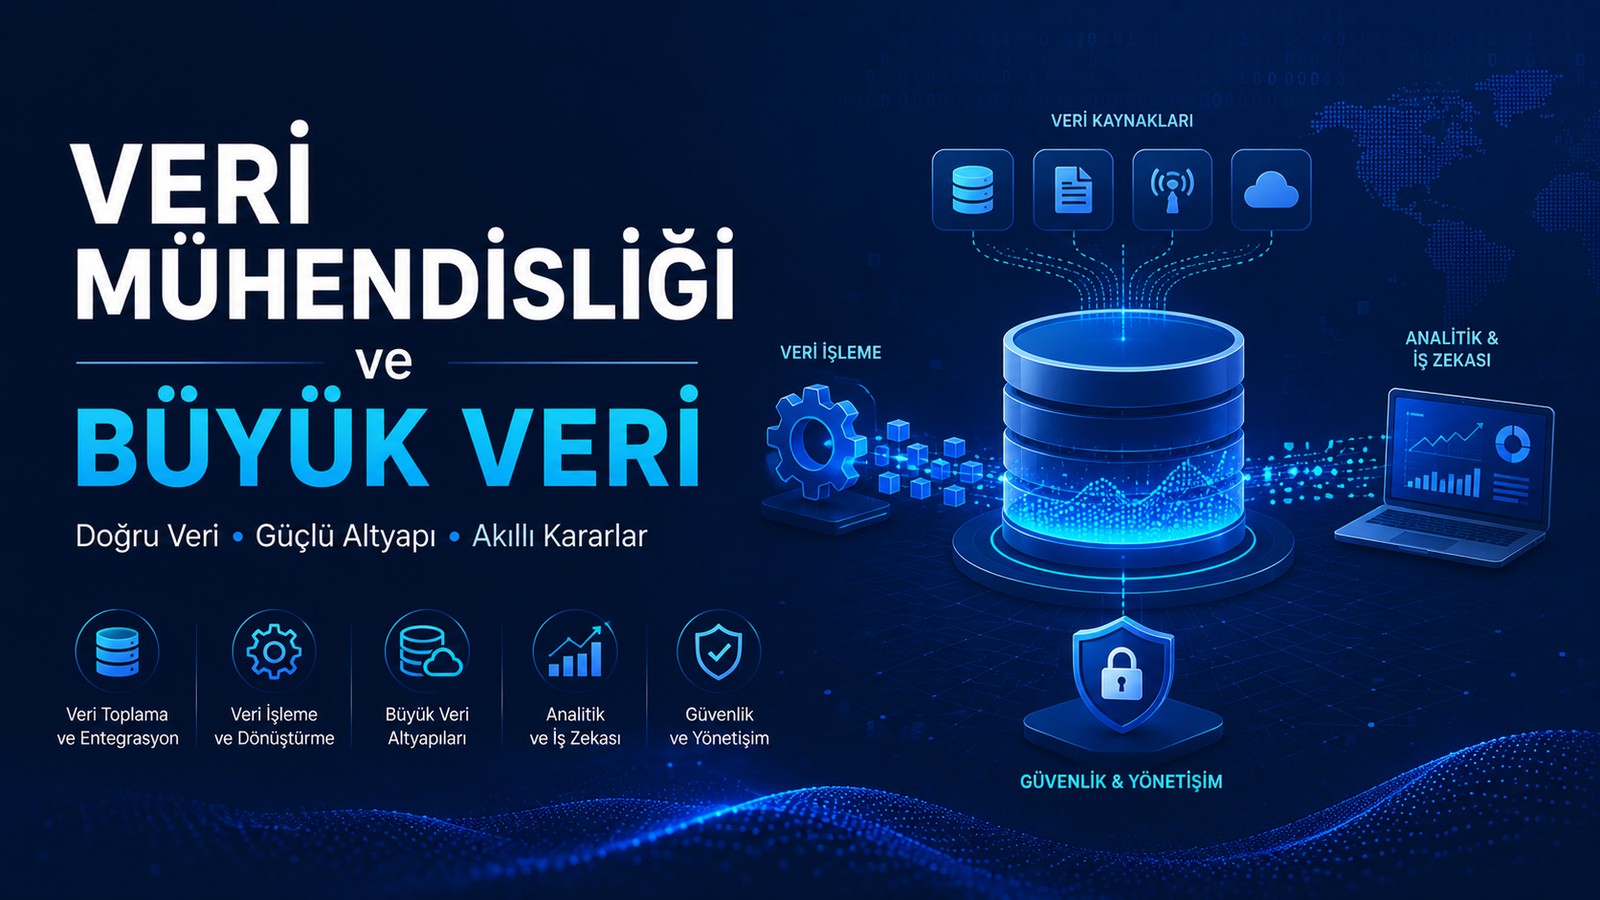
Veri Mühendisliği ve Büyük Veri: Modern Veri Platformlarını İnşa Etmek
Günümüzde veri, işletmelerin en değerli varlıklarından biri haline gelmiştir. Ancak ham verinin anlamlı içgörülere dönüştürülmesi, sağlam bir veri altyapısı gerektirir. Veri Mühendisliği, verilerin toplanması, işlenmesi, depolanması ve analiz için hazır hale getirilmesi süreçlerini kapsayan disiplindir. Büyük Veri ise geleneksel veritabanı sistemlerinin işleyemeyeceği kadar büyük, hızlı ve çeşitli veri kümelerini ifade eder. Bu yazıda, modern veri mühendisliğinin temel prensiplerini, büyük veri mimarilerini, ETL/ELT süreçlerini, dağıtık işleme çerçevelerini, veri kalitesi ve güvenlik stratejilerini, araçları ve 2025-2026 trendlerini detaylıca ele alacağız.
1. Veri Mühendisliği Nedir? Roller ve Sorumluluklar
Veri mühendisliği; veri bilimcileri, analistler ve iş karar vericileri için veriyi erişilebilir, güvenilir ve kullanılabilir kılmayı amaçlar. Veri mühendislerinin temel sorumlulukları şunlardır:
-
Veri Altyapısı Tasarlama ve Kurma: Veri depolama, işleme ve aktarım sistemlerini (data pipelines) tasarlamak ve yönetmek.
-
ETL/ELT Süreçleri Geliştirme: Verileri kaynaklardan çekip (Extract), dönüştürüp (Transform) ve hedef sisteme yüklemek (Load).
-
Veri Kalitesi ve Güvenliği Sağlama: Verilerin doğru, tutarlı ve güvenli olmasını sağlamak.
-
Performans ve Ölçeklenebilirlik Optimizasyonu: Veri işleme süreçlerinin hızlı ve ölçeklenebilir olmasını sağlamak.
-
Veri Gözlemlenebilirliği (Data Observability): Veri akışlarını izlemek, hataları tespit etmek ve veri kalitesini sürekli kontrol etmek.
2. Modern Büyük Veri Mimarileri
Geleneksel veri ambarı (data warehouse) yaklaşımlarının yetersiz kaldığı noktada, modern büyük veri mimarileri devreye girer. Günümüzde üç ana mimari model öne çıkmaktadır:
A. Data Lakehouse (Veri Göl Evi)
Data Lakehouse, veri gölü (data lake) ve veri ambarının (data warehouse) en iyi özelliklerini birleştiren hibrit bir mimaridir. Veri gölünün esnekliğini ve düşük maliyetli depolamasını, veri ambarının ise güçlü sorgulama ve yönetim yeteneklerini bir araya getirir.
-
Avantajları: Tek bir platformda hem ham veri hem de yapılandırılmış veri depolama; SQL ile doğrudan sorgulama; ACID işlem desteği; ölçeklenebilirlik.
-
Popüler Platformlar: Databricks Lakehouse, Apache Iceberg, Delta Lake, Apache Hudi.
-
.NET Uyumluluğu: .NET uygulamaları, Spark Connector veya REST API'ler aracılığıyla Lakehouse platformlarına bağlanabilir.
B. Data Mesh (Veri Ağı)
Data Mesh, veri sahipliğini ve yönetimini merkezileştirmek yerine, iş alanlarına (domain) göre dağıtan bir organizasyonel ve mimari yaklaşımdır. Her iş alanı, kendi veri ürünlerinden (data products) sorumludur ve bu ürünleri standart API'ler aracılığıyla sunar.
-
Avantajları: Merkezi olmayan yönetim; daha hızlı veri erişimi; ölçeklenebilirlik; ekip özerkliği.
-
Zorlukları: Veri ürünlerinin standartlaştırılması; federatif veri yönetimi; kültürel değişim.
C. Data Fabric (Veri Dokusu)
Data Fabric, farklı veri kaynaklarını, platformları ve ortamları entegre eden, veri yönetimini otomatikleştiren ve uçtan uca veri görünürlüğü sağlayan bir mimari yaklaşımdır. Yapay zeka ve otomasyonu yoğun şekilde kullanır.
3. ETL ve ELT: Veri Entegrasyonunda İki Farklı Yaklaşım
Veri entegrasyonu, veri mühendisliğinin temel taşıdır. İki ana yaklaşım bulunur:
| Özellik | ETL (Extract, Transform, Load) | ELT (Extract, Load, Transform) |
|---|---|---|
| Dönüşüm Zamanı | Veri yüklenmeden önce dönüştürülür. | Veri yüklendikten sonra dönüştürülür. |
| Hedef Sistem | Veri ambarı (Data Warehouse) | Veri gölü (Data Lake) veya Lakehouse |
| Avantajları | Daha temiz ve yapılandırılmış veri; hedef sistemde daha az işlem yükü. | Esneklik; tüm ham veri saklanır; dönüşüm ihtiyaç değiştikçe yeniden yapılabilir. |
| Dezavantajları | Dönüşüm sırasında veri kaybı riski; esneklik kısıtlı. | Hedef sistemde daha fazla depolama ve işlem gücü gerekir. |
| Popüler Araçlar | Talend, Informatica, SSIS | dbt, Apache Spark, Snowflake, Databricks |
Günümüzde, veri gölü ve lakehouse mimarilerinin yaygınlaşmasıyla birlikte ELT yaklaşımı daha popüler hale gelmiştir.
4. Dağıtık İşleme Çerçeveleri: Spark ve Flink
Büyük veri işleme, tek bir makinenin kapasitesini aşar. Dağıtık işleme çerçeveleri, veriyi birden fazla makineye dağıtarak paralel işlem yapılmasını sağlar.
A. Apache Spark
Spark, büyük veri işleme için en yaygın kullanılan açık kaynak çerçevedir. Hem toplu işleme (batch) hem de akış işleme (streaming) için kullanılabilir.
-
Güçlü Yönleri:
-
Toplu İşleme (Batch): Büyük veri kümeleri üzerinde ETL, veri dönüşümü ve analiz için idealdir.
-
SQL Desteği: Spark SQL ile SQL sorguları çalıştırılabilir.
-
Makine Öğrenmesi: MLlib kütüphanesi ile ölçeklenebilir makine öğrenmesi.
-
Geniş Ekosistem: Büyük bir topluluk ve zengin kütüphane desteği.
-
-
Akış İşleme (Streaming): Spark Streaming veya Structured Streaming ile mikro-batch yaklaşımı kullanır; bu nedenle gecikme (latency) Flink'e göre daha yüksektir (100 ms - 1 saniye).
.NET ile Spark Kullanımı: Microsoft.Spark paketi ile .NET uygulamalarından Spark işleri çalıştırılabilir.
B. Apache Flink
Flink, özellikle gerçek zamanlı akış işleme (real-time stream processing) için tasarlanmış bir çerçevedir.
-
Güçlü Yönleri:
-
Düşük Gecikme (Low Latency): Ortalama 5 milisaniye altında gecikme ile milyonlarca olayı saniyede işleyebilir.
-
Durum Yönetimi (State Management): Karmaşık, durumlu (stateful) akış işlemleri için güçlü destek.
-
Olay Zamanı (Event Time) İşleme: Verilerin gerçek zamanlı ve yeniden oynatılabilir (replay) işlenmesi.
-
-
Zayıf Yönleri: Toplu işleme (batch) yetenekleri Spark kadar olgun değildir; öğrenme eğrisi daha dik olabilir.
Hangi Çerçeve Ne Zaman?
-
Spark: Büyük ölçekli toplu işlemler, veri dönüşümleri (ETL), makine öğrenmesi iş yükleri ve daha düşük gecikme toleransı olan akış işlemleri (saniye seviyesi) için.
-
Flink: Gerçek zamanlı analitik, olay odaklı uygulamalar, sensör verisi işleme, sürekli sorgulamalar gibi milisaniye seviyesinde gecikme gerektiren akış işlemleri için.
5. Veri Kalitesi (Data Quality) ve Gözlemlenebilirlik (Observability)
Veri mühendisliğinde "çöp veri, çöp içgörü" (garbage in, garbage out) prensibi geçerlidir. Veri kalitesi ve gözlemlenebilirlik, güvenilir veri platformlarının olmazsa olmazıdır.
-
Veri Kalitesi Kontrolleri:
-
Şema Doğrulama (Schema Validation): Verilerin beklenen şemaya uygun olup olmadığını kontrol etme.
-
Veri Bütünlüğü (Data Integrity): Birincil anahtar, yabancı anahtar, benzersizlik gibi kısıtlamaları doğrulama.
-
Veri Doğruluğu (Accuracy): Verilerin gerçek dünyayı ne kadar doğru yansıttığını kontrol etme.
-
Veri Tamlığı (Completeness): Eksik veya boş değerleri tespit etme.
-
Zamanlılık (Timeliness): Verilerin ne kadar güncel olduğunu izleme.
-
-
Veri Gözlemlenebilirliği:
Veri kalitesini ve veri akışlarının sağlığını sürekli izleme, anormallikleri tespit etme ve hata ayıklama sürecidir.-
Metrikler: Veri hacmi, gecikme, hata oranları, şema değişiklikleri.
-
Araçlar: Great Expectations, Monte Carlo, dbt testleri, Apache Airflow gözlemlenebilirlik entegrasyonları.
-
6. Veri Güvenliği ve Yönetişim (Governance)
Büyük veri sistemlerinde güvenlik ve uyumluluk (compliance) kritik öneme sahiptir.
-
Erişim Kontrolü (Access Control): Verilere kimlerin erişebileceğini (RBAC, ABAC) ve hangi işlemleri yapabileceğini kontrol etme.
-
Veri Maskeleme (Data Masking): Hassas verileri (PII) yetkisiz erişime karşı gizleme.
-
Şifreleme (Encryption): Verileri hem depolama sırasında (at-rest) hem de aktarım sırasında (in-transit) şifreleme.
-
Veri Soy Ağacı (Data Lineage): Verilerin nereden geldiğini, nasıl dönüştürüldüğünü ve nereye gittiğini izleme.
-
Uyumluluk (Compliance): GDPR, KVKK, HIPAA gibi düzenlemelere uyumu sağlama.
7. Veri Mühendisliğinde Popüler Araçlar (2025)
| Alan | Araçlar |
|---|---|
| Orkestrasyon (Pipeline Yönetimi) | Apache Airflow, Prefect, Dagster, Azure Data Factory |
| Veri Entegrasyonu (ELT/ETL) | Fivetran, Airbyte, Meltano, dbt, Stitch |
| Dağıtık İşleme | Apache Spark, Apache Flink, Dask |
| Veri Depolama (Lakehouse) | Databricks, Snowflake, Apache Iceberg, Delta Lake, Apache Hudi |
| Veri Ambarı (Data Warehouse) | Snowflake, Google BigQuery, Amazon Redshift, Azure Synapse |
| Akış İşleme (Streaming) | Apache Kafka, Apache Flink, AWS Kinesis, Azure Event Hubs |
| Veri Kalitesi & Gözlemlenebilirlik | Great Expectations, Monte Carlo, dbt tests, Soda |
| Veri Kataloğu (Metadata Yönetimi) | AWS Glue, Amundsen, DataHub, Alation |
8. 2025-2026 Veri Mühendisliği Trendleri
-
Yapay Zeka ve Veri Mühendisliğinin Entegrasyonu: Veri mühendisleri, artık sadece ETL kodlamaktan ziyade, sistem tasarımı, veri yönetişimi, uyumluluk ve stratejik AI araç entegrasyonu gibi daha üst düzey sorumluluklar üstleniyor. AI, veri kalitesi testleri ve pipeline optimizasyonunda yardımcı oluyor.
-
GPU Yerel (GPU-Native) Hesaplama: Büyük veri ve AI iş yükleri için GPU'lar giderek daha fazla kullanılıyor.
-
Lakehouse Formatlarının Yükselişi: Apache Iceberg, Delta Lake ve Hudi, veri gölü evlerinin (lakehouse) temel formatları haline geliyor.
-
Semantik Katmanların (Semantic Layers) Yükselişi: Veri mühendisleri, tüketim katmanına daha yakın çalışıyor ve iş mantığını veri modellerine entegre ediyor.
-
Veri Ürünü Yaklaşımı (Data as a Product): Veri pipeline'ları, SLAs (Service Level Agreements) ile ürün olarak ele alınıyor.
-
No-Code / Low-Code Veri Mühendisliği: Daha az kod ile veri pipeline'ları oluşturmayı sağlayan araçlar yaygınlaşıyor.
-
Veri Yönetişiminin Otomasyonu: Yapay zeka ile veri yönetişimi otomatikleşiyor.
9. Veri Mühendisliğinde En İyi Pratikler (Best Practices)
-
Pipeline'ları Modüler ve Yeniden Kullanılabilir Tasarlayın: Kodu tekrar kullanmayı ve bakımı kolaylaştırmayı sağlayın.
-
Idempotency (Yinelenebilirlik) Sağlayın: Aynı pipeline'ı yeniden çalıştırmanın, sistemde istenmeyen yan etkilere yol açmamasını garanti edin.
-
Her Aşamada Veri Validasyonu Yapın: Veriyi pipeline'ın her adımında doğrulayın.
-
Otomatik Test ve CI/CD Uygulayın: Veri pipeline'ları için birim testleri, entegrasyon testleri ve sürekli entegrasyon/sürekli dağıtım (CI/CD) kurun.
-
Veri Soy Ağacını (Data Lineage) ve Metadata'yı İzleyin: Verilerin nereden geldiğini ve nasıl dönüştürüldüğünü takip edin.
-
Pipeline'ları Gözlemleyin ve Uyarılar Kurun: Başarısızlıkları ve anormallikleri anında tespit edin.
-
Güvenliği En Baştan Tasarlayın (Shift-Left): Veri güvenliğini ve gizliliğini pipeline tasarımının ilk aşamalarında göz önünde bulundurun.
-
ELT Paradigmasını Benimseyin: Ham veriyi saklayıp dönüşümleri daha sonra yapmak, esneklik sağlar.
Sonuç:
Veri mühendisliği ve büyük veri, modern işletmelerin veri odaklı karar almasının temelini oluşturur. Başarılı bir veri stratejisi, doğru mimari seçimleri (Lakehouse, Data Mesh), güçlü ETL/ELT süreçleri, ölçeklenebilir işleme çerçeveleri (Spark, Flink), sıkı veri kalitesi ve güvenlik kontrolleri ile mümkündür. 2025 ve sonrasında, yapay zeka entegrasyonu, GPU hesaplama ve gelişmiş veri formatları (Iceberg, Delta Lake) veri mühendisliğini yeniden şekillendirmeye devam edecektir.
Size Tavsiyem:
-
İhtiyacınıza uygun mimariyi (Lakehouse veya Data Mesh) seçerek işe başlayın.
-
Veri kalitesi ve gözlemlenebilirliği pipeline'larınıza en baştan entegre edin.
-
Dağıtık işleme çerçevelerinden (Spark/Flink) en az birinde uzmanlaşın.
-
Veri güvenliğini ve yönetişim (governance) süreçlerini ihmal etmeyin.
-
Veri pipeline'larınızı ürün olarak ele alın ve sürekli iyileştirin.